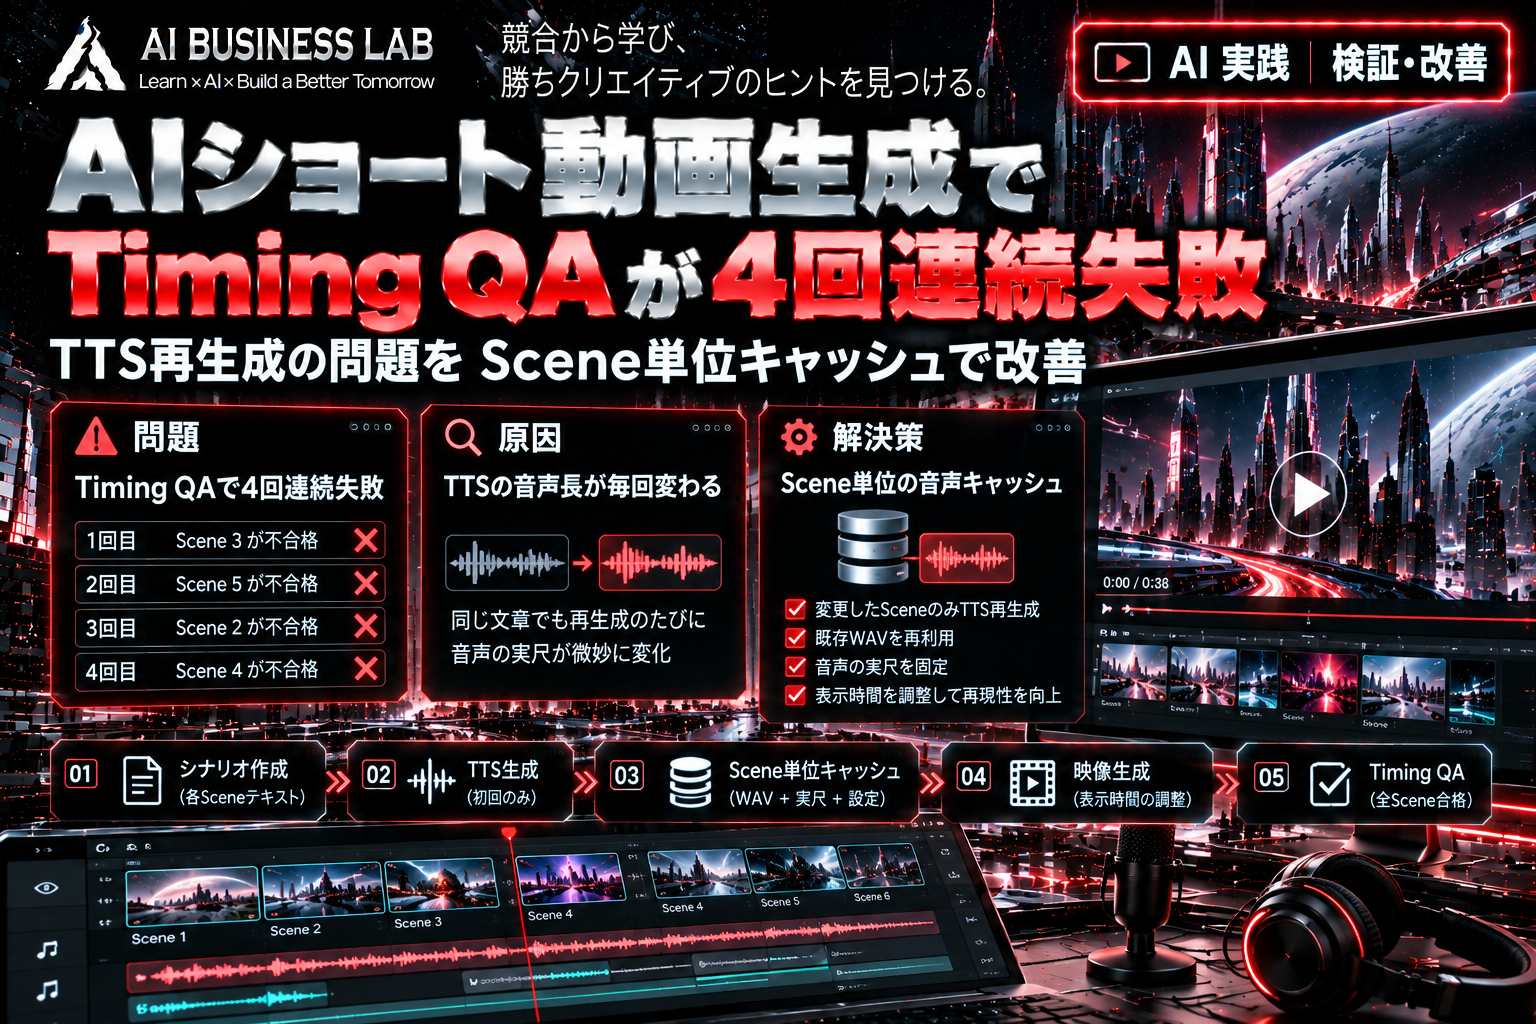
AIを使ってショート動画を自動生成する仕組みを開発しています。
今回は、これまでのUI中心の映像から一歩進め、未来都市を舞台にした新しいRenderer(映像描画プログラム)を制作しました。
ところが動画を生成すると、ナレーションと映像の時間を確認するTiming QAで、4回連続の安全停止が発生しました。
あるSceneを修正すると、今度は別のSceneが不合格になる。修正を繰り返しても問題が解消しません。
原因を調べると、Revision(修正版の生成)のたびにTTS音声を作り直していたことが問題の一つでした。
今回は、Scene単位の音声キャッシュを導入し、Timing QAを通過するまでの改善過程を記録します。
この記事で分かること
- Timing QAで4回連続失敗した状況
- TTSの再生成が問題になった理由
- Scene単位のWAVキャッシュの仕組み
- 改善後のテスト結果と学んだこと
未来都市Rendererで発生したTiming QAの問題
今回の動画生成では、未来都市を背景に、ナレーション・字幕・映像を自動的に組み合わせる仕組みを制作しました。
動画は複数のScene(場面)で構成され、それぞれに表示時間が設定されています。
例えば、Sceneの表示時間が5秒なのにナレーションが5.5秒続けば、音声が次の場面にはみ出します。
こうした問題を防ぐために設けているのが、**Timing QA(時間の品質チェック)**です。
音声と映像の時間が基準を満たさない場合、完成動画として出力せず、安全停止します。
今回も安全停止自体は正常に機能していました。
問題は、Sceneの表示時間を修正しても、次の生成で別のSceneが不合格になることでした。
修正するたびに不合格のSceneが変わった
最初は、ナレーションに対してSceneの表示時間が短いだけだと考えました。
そこで、問題のあるSceneのduration(表示時間)を延長しました。
しかし再生成すると、それまで問題のなかった別のSceneが不合格になります。
さらに修正しても、別のSceneで同じ問題が発生しました。
結果として、Timing QAによる安全停止が4回連続で発生しました。
ここで疑問になったのが、なぜ修正していないSceneまで不合格になるのかという点です。
単純な表示時間の設定ミスでは説明できないため、動画生成の処理を確認しました。
原因はTTS音声の実尺が変わることだった
TTS(Text-to-Speech)は、文章からナレーション音声を生成する技術です。
今回のシステムでは、Sceneごとの文章からTTSで音声を生成していました。
当初は、同じ文章と設定なら、生成される音声の長さも同じだと考えていました。
しかし実際には、再生成するたびに音声の実尺が微妙に変化する場合がありました。
さらに問題だったのは、Sceneを一つ修正するだけでも、ほかのSceneの音声まで再生成していたことです。
例えばScene 3の表示時間を変更しても、Scene 1・2・4・5・6の音声が作り直されます。
その結果、以前は時間内に収まっていた音声が少し長くなり、次のTiming QAで不合格になることがありました。
問題はSceneの表示時間だけでなく、Revisionごとに音声が変化する設計にもありました。
Scene単位のWAVキャッシュを導入
そこで、一度生成した音声を再利用する方式へ変更しました。
キャッシュとは、生成済みのデータを保存し、同じ処理が必要になったときに再利用する仕組みです。
今回は動画全体ではなく、Scene単位でWAV音声を保存します。
例えば6つのSceneがあり、Scene 3のナレーションだけを変更した場合は、次のように処理します。
| Scene | 音声の処理 |
|---|---|
| Scene 1・2 | 既存WAVを再利用 |
| Scene 3 | TTSを再生成 |
| Scene 4・5・6 | 既存WAVを再利用 |
これなら、変更していないSceneの音声尺が再生成によって変わることはありません。
また、映像のdurationだけを変更した場合は、TTSを呼び出さず、保存済みWAVの実尺を基準に調整できます。
キャッシュの一致確認と再利用履歴も記録
単にWAVを保存するだけでは、間違った音声を再利用する可能性があります。
そこで、ナレーション本文とTTS設定から作成したハッシュ値、WAVファイルのSHA-256、実際の再生時間なども記録する仕組みにしました。
ハッシュ値は、データが同じかどうかを確認するための識別情報です。
本文や設定が一致し、保存ファイルにも問題がない場合に、既存音声を再利用します。
さらに再利用したSceneには、generation_mode: reusedという記録を残します。
これにより、どの音声を新しく生成し、どの音声を再利用したのかを後から確認できるようにしました。
Timing QAの余裕時間も見直した
音声キャッシュとあわせて、Timing QAの基準も見直しました。
今回は、各Sceneについて最低0.50秒の余裕時間を確保する基準に変更しています。
音声が終了した瞬間に次のSceneへ切り替わるのではなく、一定の余白を設けるためです。
また、Timing QAで不合格になった場合は、まずScene間の時間配分を調整し、それでも難しい場合に必要なSceneのナレーションを短くする方針にしました。
音声を固定することで、表示時間の調整結果を次のRevisionでも利用しやすくなりました。
69件のテストに合格し、最終Revisionも通過
Scene単位のキャッシュを実装した後、関連処理についてテストを行いました。
結果は、69件すべて合格。実装に起因するテスト失敗は0件でした。
ただし、コードのテストに合格しても、実際の動画がTiming QAを通過するとは限りません。
そこで未来都市Rendererでの生成に戻り、6つのSceneのWAVを固定しました。
一部のSceneでは時間不足が残っていましたが、今度は音声を再生成せず、映像側のdurationを調整しました。
最終Revisionでは、各Sceneにおおむね0.7秒程度の余裕を確保するように時間を再配分しました。
その結果、全SceneのTiming QAに合格しました。
さらに、最終RevisionでのTTS/API追加呼び出しは0回でした。
既存WAVを再利用し、映像の時間調整だけで問題を解消できたことになります。
こうして未来都市Rendererの第1号動画を完成させることができました。
今回の改善で学んだこと
音声キャッシュを導入すれば、不要なTTS API呼び出しを減らせるため、コスト削減も期待できます。
しかし、今回特に重要だと感じたのは再現性です。
Revisionのたびに音声尺が変わる状態では、前回の検証結果を次の修正に活かしにくくなります。
一方、確定したWAVを固定すれば、その実尺を基準として映像を調整できます。
また、最初は個別のSceneのエラーを修正していましたが、4回連続で失敗したことで、生成処理そのものを見直す必要があると分かりました。
失敗したSceneだけを直すのではなく、失敗が繰り返される原因を仕組みから改善する。
これが今回の大きな学びです。
まとめ|生成する部分と固定する部分を分ける
未来都市Rendererの開発では、Timing QAによる安全停止が4回連続で発生しました。
原因を調べた結果、RevisionごとのTTS再生成によって、修正していないSceneの音声尺まで変わることが問題の一つだと分かりました。
そこでScene単位のWAVキャッシュを導入し、変更していない音声は再利用する方式に改善しました。
その結果、69件のテストに合格し、最終RevisionではTTS/API追加呼び出し0回で全SceneのTiming QAを通過しました。
今回の経験から、AIによる自動化では、何を生成するかだけでなく、何を固定して再利用するかも重要だと分かりました。
今後も、映像表現を広げるだけでなく、安定して繰り返し生成できる仕組みを少しずつ改善していきます。