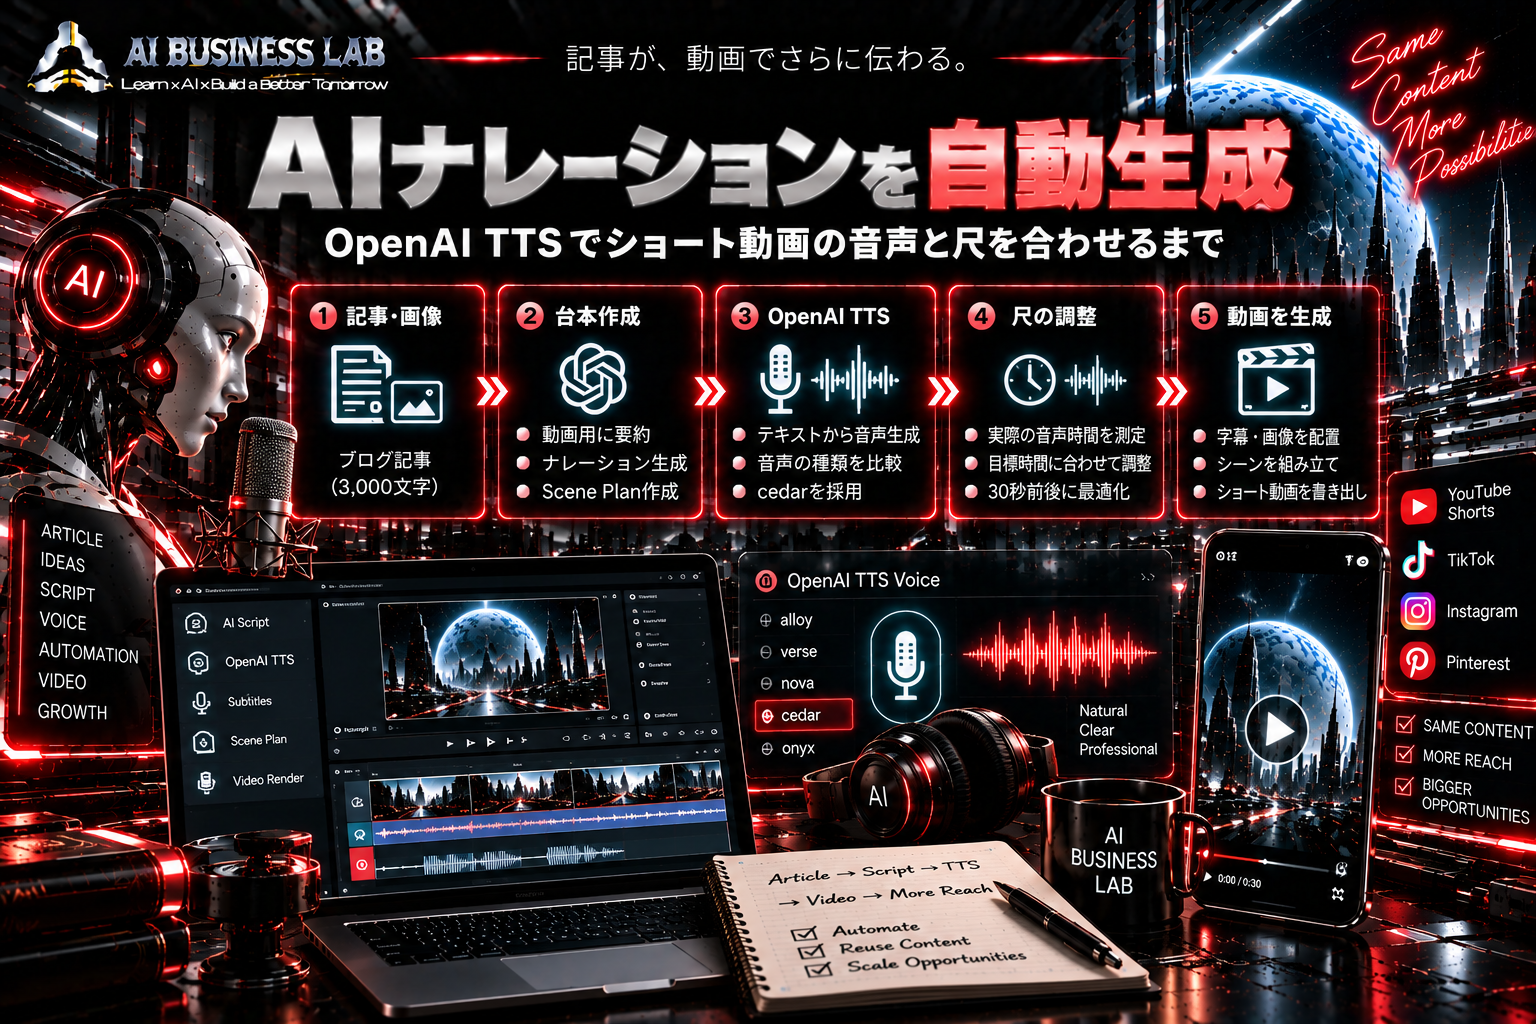
ブログ記事からショート動画を自動生成するシステムを作る中で、避けて通れなかったのがナレーションの自動化です。
記事から動画テーマを抽出し、Scene Planを作り、Pythonで画像や字幕を配置できても、毎回自分で音声を録音するのでは自動化が途中で止まってしまいます。
そこでOpenAIのText-to-Speech(TTS)をPythonから利用し、ナレーションも自動生成することにしました。
ところが実際に試してみると、難しかったのは音声生成そのものではありません。
「30秒程度の動画に、実際のナレーション時間をどう合わせるか」
という問題でした。
最初に生成した動画は約105秒。そこから音声の実時間をPythonで測定し、動画の尺を調整する仕組みへ変更しました。
この記事で分かること
- OpenAI TTSを動画生成へ組み込む考え方
- 3種類の音声からcedarを選んだ理由
- 30秒想定が約105秒になった原因
- 実際の音声時間からSceneを決める方法
- 「生成→実測→修正」を自動化する考え方
ナレーションもPythonから自動生成する
今回作っているシステムは、
記事 → 動画テーマ抽出 → Scene Plan → ナレーション → 字幕・画像 → 動画
という流れを目指しています。
1記事から複数のショート動画を作るなら、ナレーションも自動化した方が全体の仕組みと相性がよくなります。
OpenAIのAudio APIにはテキストから音声を生成するSpeech機能があり、gpt-4o-mini-ttsでは声だけでなく、話す速度やトーンなども指示できます。音声はMP3やWAVなどで出力できます。(OpenAI Developers)
そのためPythonから、
台本を取得 → TTSへ送信 → 音声ファイルを保存 → 動画生成へ渡す
という処理をつなげられます。
3種類を比較してcedarを採用
最初から音声を固定せず、同じナレーションを3種類の声で生成して聞き比べました。
確認したのは、聞き取りやすさ、日本語としての違和感、話すテンポ、動画の雰囲気との相性などです。
最終的に、今回の動画生成システムではcedarを基本音声として採用しました。
現在のOpenAI公式ドキュメントでもcedarは利用可能な組み込み音声の一つで、marinとともに高品質な選択肢として推奨されています。(OpenAI Developers)
もちろん、cedarがすべての用途で最適という意味ではありません。今回は実際に聞き比べた結果、自分が作りたい動画に合うと判断しました。
最初の動画が約105秒になった
音声生成そのものはできましたが、ここで大きな問題が発生しました。
30秒程度を想定していたショート動画が、約105秒になったのです。
原因は、Scene Planで設定した時間と、TTSが実際に文章を読み上げる時間が一致していなかったことでした。
例えばAIがSceneを8秒と設計していても、ナレーションを実際に生成すると15秒かかる場合があります。
これが複数Sceneで積み重なると、想定より大幅に長い動画になります。
文字数だけでは正確な音声時間が分からない
当初は、文字数から読み上げ時間を推定する方法も考えました。
確かに台本作成時の目安には使えます。しかし実際の読み上げ時間には、句読点、数字、英単語、文章構造、話す速度や間なども影響します。
そこで、
事前の文字数=尺の目安
生成した音声=実際の尺
と分けて扱うことにしました。
動画を最終的に組み立てるときは、推定値ではなく生成済み音声の実時間を基準にします。
Scene Planを実音声尺に合わせる
最初のScene Planでは、
「Scene1=3秒」「Scene2=8秒」
のように時間を先に決めていました。
これを逆にします。
まずAIがナレーションを作成し、TTSで音声化。その音声ファイルの長さをPythonで取得します。
例えば音声が7.4秒なら、7秒の枠へ無理に押し込まず、7.4秒+必要な余白をScene時間として設定します。
これによって、映像だけ先に終わったり、音声を不自然に高速化したりする問題を減らせます。
実音声に合わせるだけでは動画は短くならない
ただし、ここでも問題があります。
105秒の音声に映像を正確に合わせれば、完成するのはきれいに同期した105秒の動画です。
ショート動画を30秒程度にしたいという目的は達成できません。
そこで必要になったのが、
目標尺を超えたら台本そのものを短くする
という処理です。
例えば目標30秒に対して実音声が42秒なら、「12秒程度長い」という情報をAIへ戻します。
AIが重要な内容を残しながら台本を短縮し、再びTTSで音声を生成。Pythonでもう一度実時間を測ります。
32秒になり、設定した許容範囲内なら採用する、という流れです。
「生成→実測→修正」のループを作る
この経験から、ナレーション生成は一度で完成させる処理ではなく、
AIで台本作成 → TTS生成 → Pythonで実測 → 目標尺と比較 → AIで修正 → 再生成
というループにした方がよいと考えるようになりました。
例えば目標30秒、許容範囲27〜35秒と設定しておけば、範囲外の場合だけ再調整する仕組みも作れます。
Pythonが時間を測定し、AIが文章を修正する。それぞれが得意な処理を担当します。
音声を動画タイムラインの基準にする
今回の実装で特に大きく変わったのが、音声の位置付けです。
当初は、
30秒の映像を作る → 音声を載せる
という発想でした。
現在は、
台本 → TTS → 実音声尺 → Scene時間 → 字幕 → 映像
という順番へ変えています。
ナレーションを後から追加する素材ではなく、動画タイムラインを決める基準データとして扱うわけです。
字幕についても実音声尺を利用すれば、Scene全体に長文を表示するのではなく、読み上げに合わせて短く切り替える設計へ発展させられます。
なお、OpenAIではTTS音声がAI生成であり、人間の声ではないことを利用者へ明確に開示することが求められています。公開時にはこの点も動画運用ルールへ組み込む必要があります。(OpenAI Developers)
まとめ
OpenAI TTSを使えば、Pythonからナレーション音声そのものを生成できます。
しかし今回実際にシステムへ組み込んで分かったのは、音声を作ることより、動画の尺へ合わせる仕組みの方が重要だったということです。
3種類の音声を比較してcedarを選び、実際に動画を生成すると約105秒になりました。
そこでScene Planの予定時間へ音声を押し込む方法をやめ、
台本 → TTS → 実音声尺を測定 → 長ければ台本修正 → Scene時間確定
という設計へ変更しました。
「30秒の動画を作って」とAIへ指示するだけではなく、生成結果をPythonで測定し、その結果を再びAIへ戻す。
生成→実測→判定→修正。
このループを作ることで、AIナレーションも動画生成システムの一部として少しずつ安定させられそうです。