Claude Codeを継続して使う中で、気になってくるのが「前回までの情報をどこまで覚えているのか?」という点です。
例えば、プロジェクトの使用技術や作業ルール、以前発生したエラーの解決方法などを、毎回説明するのは非効率です。
Claude Codeには、こうした情報をセッションをまたいで利用するためのMemory機能があります。
ただし、CLAUDE.md、Auto Memory、MEMORY.md、/memoryなど、似た名前が複数登場するため、最初は違いが分かりにくいところです。
今回は、それぞれの役割と使い分けを整理します。
この記事で分かること
- Claude CodeのMemoryの基本的な仕組み
- CLAUDE.mdとAuto Memoryの違い
- MEMORY.mdと/memoryの役割
- Memoryの保存場所と管理方法
- 長期プロジェクトでの使い分け
Claude CodeのMemoryとは?
Claude CodeのMemoryは、プロジェクトの情報や作業上の知見を保存し、別のセッションでも利用できるようにする仕組みです。
ただし、過去の会話をすべて永久に覚えているわけではありません。
必要な情報をファイルとして保存し、次の作業で参照する方式です。
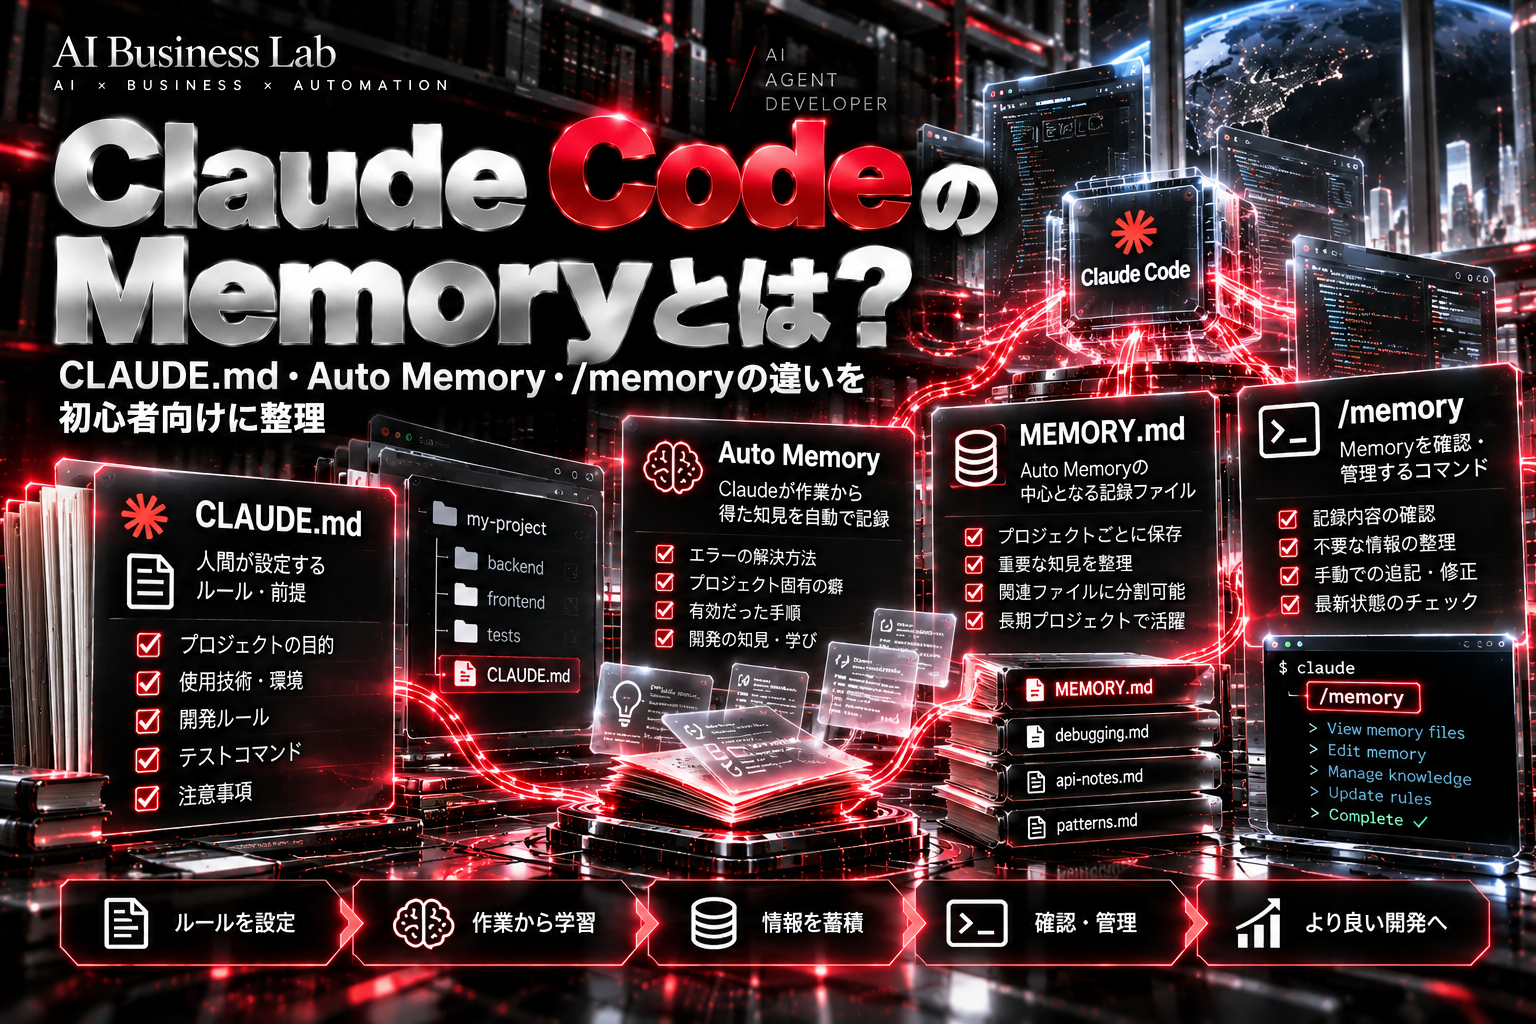
基本となるのは、次の4つです。
| 名称 | 主な役割 |
|---|---|
| CLAUDE.md | 人間が設定するルールや前提 |
| Auto Memory | Claudeが作業から得た知見を保存 |
| MEMORY.md | Auto Memoryの中心となる記録ファイル |
| /memory | Memoryを確認・管理するコマンド |
特に重要なのは、CLAUDE.mdは人間が伝えるルール、Auto MemoryはClaudeが作業から得た知見という違いです。
CLAUDE.md|人間が設定するルール
CLAUDE.mdは、Claude Codeへプロジェクトの目的や作業ルールを伝えるためのファイルです。
例えば、次のような内容を記載します。
# Project Rules

- Pythonを使用する
- SQLiteを正式なデータベースとする
- コード変更後はpytestを実行する
- 既存データを勝手に削除しない
これらは、Claudeに毎回守ってほしい共通の方針です。
CLAUDE.mdは、AIが自動的に学習した内容ではなく、人間が明示的に管理する指示として扱います。
また、プロジェクト単位やフォルダ単位で配置し、ルールを分けることもできます。
Auto Memory|Claudeが作業から得た知見を保存
Auto Memoryは、Claude Codeが作業中に得た有用な情報を、次回以降のセッションでも参照できるように保存する仕組みです。
例えば、次のような情報が考えられます。
- 特定のテストで必要になる環境設定
- 過去に発生したエラーと解決方法
- プロジェクト固有の実装上の注意点
- 繰り返し利用するデバッグ方法
CLAUDE.mdが「このルールで作業してください」という指示なら、Auto Memoryは「以前の作業でこういうことが分かった」という記録です。
ただし、Claudeがすべての出来事を自動保存するわけではありません。
保存される情報は選択的であり、内容が常に正確・最新であるとも限りません。
そのため、重要な設計方針や禁止事項をAuto Memory任せにするのは避けた方がよいでしょう。
MEMORY.md|Auto Memoryの中心となるファイル
Auto Memoryは、通常、プロジェクトごとに用意されたメモリ用ディレクトリへ保存されます。
代表的な保存場所は次のような構造です。
~/.claude/projects/<project>/memory/
├── MEMORY.md
├── debugging.md
└── api-notes.mdMEMORY.mdは、Auto Memoryの中心となるファイルです。
Claude Codeは、このファイルの先頭部分をセッション開始時に読み込みます。
詳細な情報が増えた場合は、別ファイルに分けて保存し、必要に応じて参照することもできます。
つまり、MEMORY.mdは会話履歴をすべて保存する場所ではなく、今後の作業で役立つ情報を整理するためのものです。
/memory|Memoryを確認・管理するコマンド
/memoryは、CLAUDE.mdやAuto Memoryなどを確認・管理するためのコマンドです。
名前だけを見ると、新しい種類のMemoryのように感じますが、そうではありません。
Claude Codeで次のコマンドを入力します。
/memoryすると、メモリ関連のファイルや設定を確認・編集するための操作ができます。
例えば、以前はCSVを正式な保存先としていたものの、現在はSQLiteへ変更した場合を考えます。
古い情報がMemoryに残っていると、Claudeが誤った前提で作業する可能性があります。
そのため、Memoryは保存するだけでなく、必要に応じて内容を見直すことが重要です。
CLAUDE.mdとAuto Memoryはどう使い分ける?
実際の使い分けを考えると、違いが分かりやすくなります。
| 記録したい内容 | 適した保存先 |
|---|---|
| 変更後は必ずテストする | CLAUDE.md |
| 正式DBはSQLiteを使用する | CLAUDE.md |
| 本番データを無断で削除しない | CLAUDE.md |
| 過去の認証エラーの解決方法 | Auto Memory |
| 特定ライブラリの互換性に関する知見 | Auto Memory |
| よく使うデバッグ手順 | Auto Memory |
判断基準は、今後守るべき正式なルールなのか、過去の作業から得た参考情報なのかです。
特にデータ削除の禁止や重要な設計方針などは、CLAUDE.mdへ明示しておく方が管理しやすくなります。
なお、CLAUDE.mdに記載しても、AIが必ず指示を守るとは限りません。重要な操作には権限管理や人間による確認も必要です。
Memoryは多ければよいわけではない
Auto Memoryが便利だからといって、すべての作業履歴を保存する必要はありません。
例えば「今日テストを3回実行した」という情報は、次回の開発では役立たないかもしれません。
一方、「このAPIの認証には特定の設定が必要」という情報は、繰り返し利用する可能性があります。
Memoryには、一時的な出来事よりも、再利用できる知識を残す方が効果的です。
また、情報が古くなった場合は更新・削除し、現在のプロジェクトと矛盾しない状態に保つことも大切です。
初心者はどう使い始めればよい?
最初から複雑なMemory管理を設計する必要はありません。
まずCLAUDE.mdに、プロジェクトの目的、使用技術、重要なルールを記載します。
その状態でClaude Codeを使い、作業から得た知見がAuto Memoryへ蓄積されたら、必要に応じて/memoryで確認します。
そして、正式なルールとして管理すべき内容はCLAUDE.mdへ移し、過去のトラブルや解決方法などは参考情報として残します。
このように役割を分けるだけでも、Memoryを整理しやすくなります。
まとめ|ルールと経験を分けて管理する
Claude CodeのMemoryは、過去の会話をすべて覚える仕組みではなく、必要な情報を保存して次の作業へ引き継ぐための仕組みです。
CLAUDE.mdは人間が設定する共通ルール、Auto MemoryはClaudeが作業から得た知見、MEMORY.mdはその記録ファイル、/memoryは管理するためのコマンドです。
重要なのは、すべてを同じ「記憶」として扱わないことです。
守るべきルールと、作業から得た経験を分けて保存し、必要に応じて更新する。
この考え方が、Claude Codeを長期的なプロジェクトで活用するための基本になります。
※Claude CodeのMemory機能や保存方法は変更される場合があります。最新情報は公式ドキュメントを確認してください。