ブログやSEOについて調べていると、
「Googleにインデックスされた」
「まだクロールされていない」
「クロール済みなのにインデックスされない」
といった言葉をよく見かけます。
どちらもGoogle検索に関係するため、最初は違いが分かりにくいところです。
簡単に整理すると、
クロール=Googleがページへアクセスして情報を取得すること
インデックス=取得したページを処理し、検索で利用できる情報として登録すること
です。
つまり、クロールされたからといって、必ずインデックスされるわけではありません。
今回は、クロールとインデックスの違いから、Search Consoleで見かける「インデックス未登録」の意味まで整理します。
この記事で分かること
- クロールとインデックスの違い
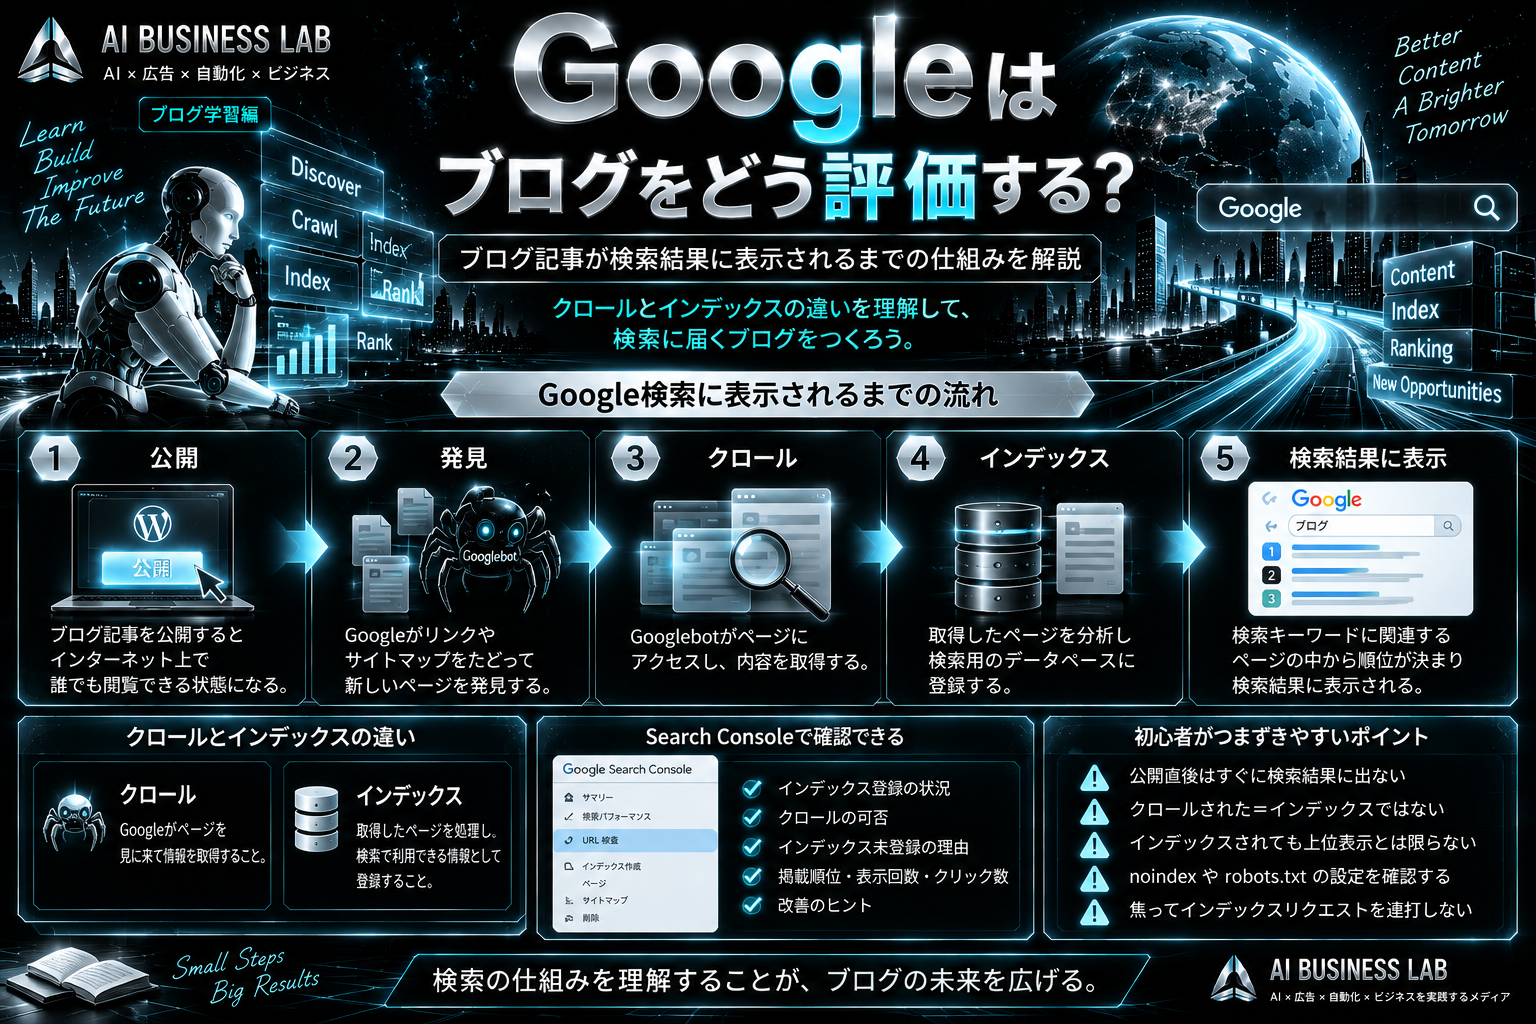
- Google検索へ表示されるまでの流れ
- 2種類の「インデックス未登録」の違い
- インデックスされない場合の確認ポイント
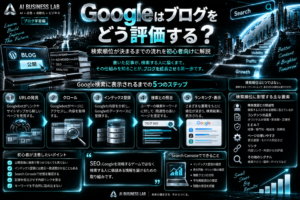
Google検索はその場でWeb全体を探しているわけではない
Googleで何かを検索したとき、その瞬間にGoogleが世界中のWebサイトを巡回しているわけではありません。
Googleは事前にWebページを発見してクロールし、その内容を処理してインデックスを作っています。
ユーザーが検索したときには、その情報などを利用して検索結果を生成します。
大まかな流れは、
URLを発見 → クロール → インデックス登録 → 検索結果への表示
です。
この流れを理解すると、クロールとインデックスの違いも分かりやすくなります。
クロールとは?Googlebotがページを取得する
クロールとは、GoogleがWebページへアクセスして情報を取得することです。
代表的なクローラーがGooglebotです。
Googleはリンクやサイトマップなどを手掛かりにURLを発見します。
例えば、すでにGoogleが知っている記事Aから新しい記事Bへ内部リンクが張られていれば、記事AをクロールしたGooglebotが記事Bを発見する可能性があります。
XMLサイトマップも、新しいURLをGoogleへ知らせる手掛かりになります。
ただし、
URLを発見した=すぐクロールされる
とは限りません。
GoogleがURLの存在を認識することと、実際にページへアクセスして情報を取得することも別の段階です。
インデックスとは?検索で利用する情報として登録する
Googlebotがページをクロールすると、Googleは取得した内容を処理します。
本文、タイトル、画像、動画などを分析し、
「このページは何について書かれているのか」
を理解していきます。
そのうえで検索に利用する情報としてGoogleのインデックスへ保存されるのが、インデックス登録です。
図書館に例えるなら、
クロール=新しい本を見つけて内容を確認する
インデックス=本を分類して蔵書データベースへ登録する
というイメージです。
そのため、Googlebotが記事へアクセスしただけでは、まだ検索結果へ登録されたとは限りません。
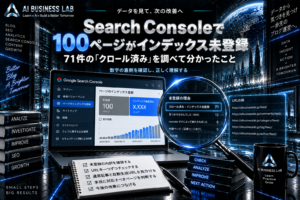
「検出 – インデックス未登録」とは?
Search Consoleでは、
「検出 – インデックス未登録」
という表示を見ることがあります。
これは簡単に言えば、
GoogleはURLの存在を知っているものの、まだクロールしていない状態
です。
例えばサイトマップや内部リンクなどからURLは発見したものの、Googlebotによるページ取得がまだ行われていないケースです。
処理の流れでは、
URL発見 → クロール待ち
の段階と考えると分かりやすいでしょう。
「クロール済み – インデックス未登録」とは?
一方、
「クロール済み – インデックス未登録」
は意味が異なります。
こちらは、
Googleはページをクロールしたものの、現時点ではインデックスしていない状態
です。
つまり、
検出 – インデックス未登録
=URLは知っているが、まだクロールしていない
クロール済み – インデックス未登録
=ページを取得したが、現在はインデックスしていない
という違いがあります。
同じ「インデックス未登録」でも、Google側の処理がどこまで進んでいるかが違うわけです。
クロールされてもインデックスされないことがある
ここで重要なのが、
クロール=インデックスではない
という点です。
Googleがページをクロールしても、すべてのURLがインデックスされるわけではありません。
別URLが正規ページとして選ばれている、重複・類似するページとして処理されている、noindexが設定されているなど、さまざまな理由が考えられます。
そのため、
「クロール済み – インデックス未登録=Googleからペナルティを受けた」
と判断するのは早すぎます。
まずSearch Consoleで、GoogleがそのURLをどのように認識しているのか確認する必要があります。
noindexとrobots.txtの違いも理解しておく
ここでもクロールとインデックスの違いが関係します。
大まかに整理すると、
robots.txt=クローラーによるアクセスを制御する
noindex=検索結果へのインデックス登録を制御する
ための仕組みです。
通常の記事へ誤ってnoindexが設定されていれば、Google検索へ表示されない原因になります。
一方、robots.txtでクロールを制限すれば、Googlebotがページ内容を取得できない場合があります。
検索結果に記事が出ないときは、単純に「SEOが弱い」と考えるのではなく、クロールの問題なのか、インデックスの問題なのかを切り分けることが大切です。
インデックスされた=上位表示ではない
もう一つ混同しやすいのが、インデックスと検索順位です。
Search Consoleで「URLはGoogleに登録されています」と表示されても、狙ったキーワードですぐ上位表示されるわけではありません。
インデックスは、検索結果へ表示されるための土台に載った状態です。
その後、ユーザーが検索したときに、Googleが検索内容との関連性などを判断して検索結果を生成します。
つまり、
クロール → インデックス → ランキング
もそれぞれ別の段階です。
記事がインデックスされていても、検索順位が低いため自分で検索して見つけられないことはあります。
Search Consoleで現在地を確認する
記事が検索結果に出てこない場合は、Google Search ConsoleのURL検査を使うと状態を確認できます。
大切なのは、いきなり記事を書き直すのではなく、
GoogleはURLを発見しているか
クロールしているか
インデックスしているか
を順番に確認することです。
URL検査には「インデックス登録をリクエスト」という機能もありますが、何度も押せば処理が速くなるわけではありません。
特に「クロール済み – インデックス未登録」であれば、リクエストを繰り返すより、ページの状態やSearch Consoleに表示されている内容を確認する方が重要です。
まとめ|クロールとインデックスは別々の段階
クロールとインデックスを一言で整理すると、
クロール=Googleがページを取得すること
インデックス=取得したページを検索用の情報として登録すること
です。
ブログ記事がGoogle検索へ表示されるまでには、
記事公開 → URL発見 → クロール → 内容の処理 → インデックス → ランキング → 検索結果への表示
という流れがあります。
そのため、「Googlebotが来た=検索に載る」でも、「インデックスされた=上位表示される」でもありません。
Search Consoleで「検出 – インデックス未登録」と表示されたなら、GoogleはURLを知っているもののクロール前。
「クロール済み – インデックス未登録」なら、ページを取得したものの現在はインデックスしていない状態です。
記事が検索に出てこないときは、闇雲にSEO対策を増やすのではなく、Googleの処理がどの段階まで進んでいるのかを確認する。
クロールとインデックスの違いを理解しておけば、Search Consoleの表示を見たときにも、何を確認すべきなのか判断しやすくなります。
※本記事は2026年9月時点のGoogle Search Consoleの公開情報をもとに整理しています。検索・インデックスの仕様は変更される可能性があるため、最新情報はGoogle公式情報をご確認ください。