ブログを始めた頃は、数字の確認もそれほど複雑ではありませんでした。
Google Search Consoleで検索表示回数やクリック数を確認し、GA4でアクセス状況を見る。これだけなら、それぞれの管理画面を開いて確認しても大きな負担にはなりません。
ところが、ブログ記事をPinterestやXへ展開し、さらにYouTube Shorts、Instagram、TikTokなどへ広げていくと状況が変わりました。
コンテンツはつながっているのに、数字だけがバラバラなのです。
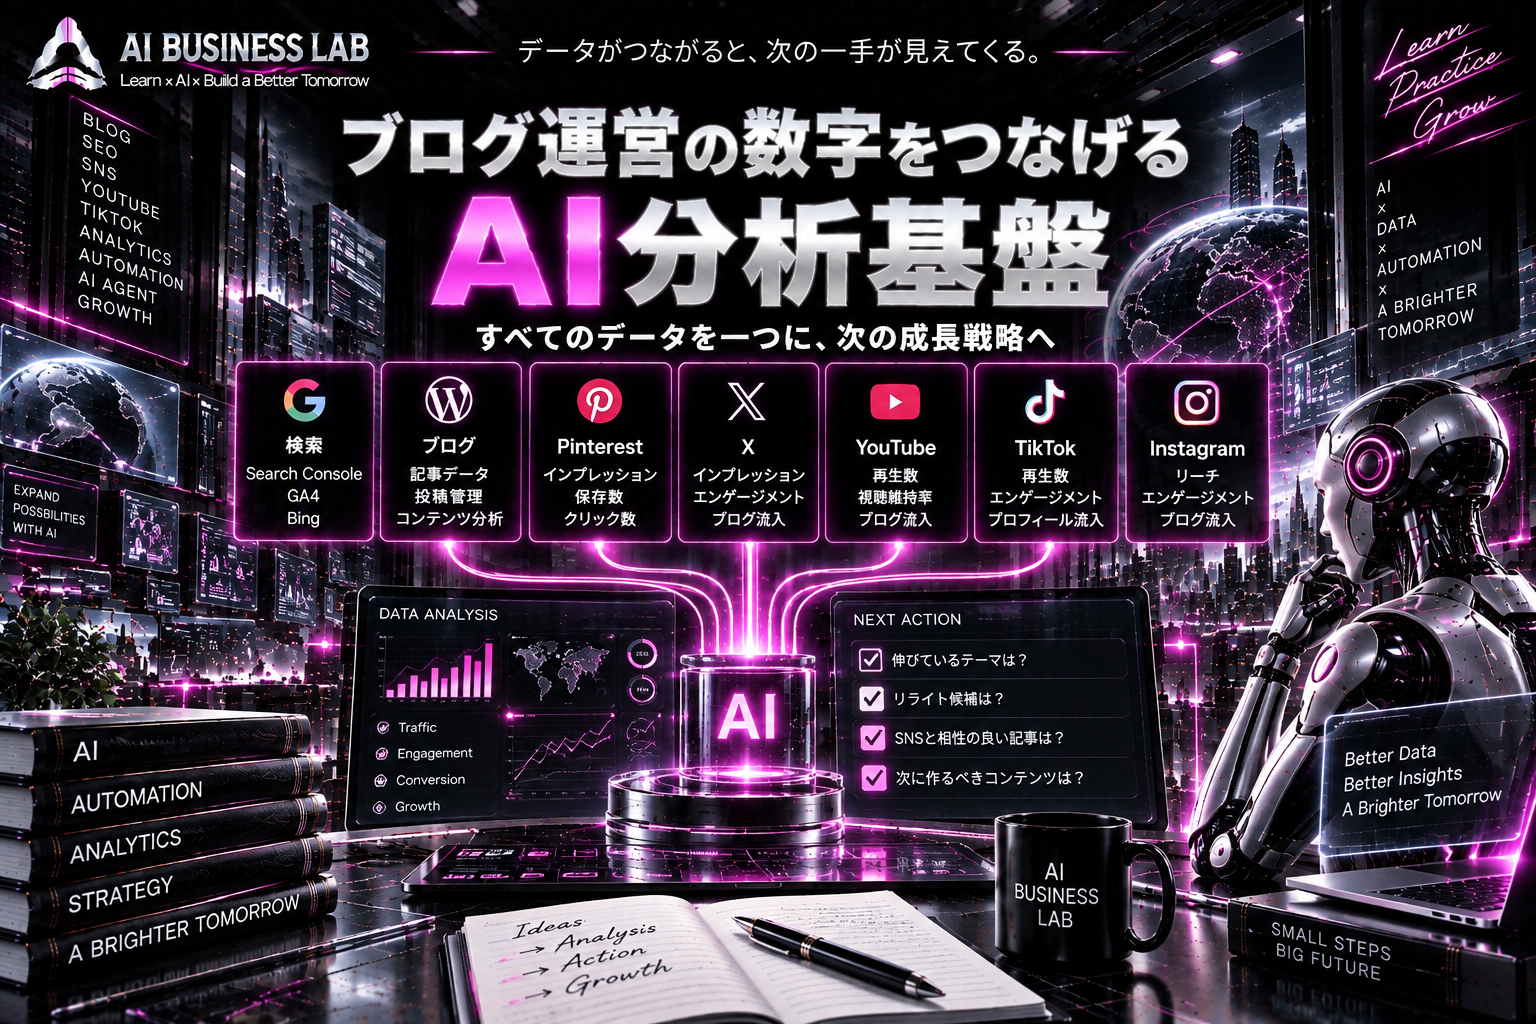
そこで現在、各媒体のデータを一か所へ集め、将来的にAIが横断的に分析できる「全媒体データ分析基盤」を作り始めています。
今回は技術的な作り方ではなく、なぜこの仕組みが必要だと考えたのかを整理します。
この記事で分かること
- ブログ・SNS運営でデータが分散する問題
- AI分析のためにデータを集約する理由
- 記事とSNS・動画をつなげる考え方
- 全媒体データ分析基盤で目指していること
媒体を増やすほど全体像が見えなくなった
ブログだけでもデータは一か所にありません。
Search Consoleでは、検索表示回数・クリック数・検索クエリ・掲載順位などを確認できます。
GA4では、サイトへ来たユーザーの流入元やページ閲覧などを確認します。さらにWordPressの記事情報があり、Bingからの検索流入もあります。
ここへPinterest、X、YouTube、Instagram、TikTokなどが加わると、データはさらに分散します。
例えば、一つの記事からPinterest画像と5本のショート動画を作ったとします。
Google検索では元記事が伸び、Pinterestでは画像の反応が良く、YouTubeでは動画A、TikTokでは動画Cが伸びるかもしれません。
本来はすべて一つのテーマに対する反応です。
しかし、それぞれ別の管理画面に存在するため、媒体をまたいだ関係が見えにくくなります。
データは増えているのに、全体像は逆に分からなくなる。これが最初に感じた問題でした。
数字を集めること自体が目的ではない
各管理画面を毎日確認して、数字をスプレッドシートへ転記する方法もあります。
ただ、媒体やコンテンツが増え続ければ、いつか限界が来ます。
しかも本当に知りたいのは数字そのものではありません。
「なぜこの記事が伸びたのか」
「検索と動画の両方で反応が良いテーマは何か」
「Pinterestでは伸びるのに検索では弱い記事はあるか」
「どのSNS投稿がブログ流入につながったのか」
「次に何を作るべきか」
こうした次の改善につながる情報を知りたいのです。
データ収集に時間を使い続けるより、収集を自動化し、人間は分析と判断へ時間を使う方が合理的だと考えるようになりました。
AIへ数字を渡すのではなく、AIが読める場所へ集める
これまでAIに分析してもらう場合は、人間がSearch ConsoleやGA4などを確認し、
「検索表示はこの数字でした」
「YouTubeではこの動画が伸びました」
とAIへ情報を渡す必要がありました。
これでは分析にAIを使っても、データ収集は人力のままです。
そこで発想を変えました。
各媒体 → 自動取得 → 共通ルールで整理 → データベース → 集計 → AI分析
という流れを最初から作ってしまいます。
人間が数字をAIへ運ぶのではなく、AIが分析できる場所へ数字を蓄積しておくという考え方です。
これが「全媒体データ分析基盤」の中心にあります。
最初はブログ数値の自動取得から始まった
当初から大規模なシステムを作ろうとしていたわけではありません。
最初の目的は、WordPressの記事情報やGA4、Search Consoleなどのデータを自動取得し、手作業での転記を減らすことでした。
ところがCodexを使って設計を考えていくうちに、
「どうせ蓄積するなら、将来のAI分析まで考えた構造にした方がよいのではないか」
と考えるようになりました。
現在はPythonとSQLiteを中心に、データ取得、保存、集計、スプレッドシートへの出力、将来のAI分析まで役割を分ける構成を検討しています。
最初はWordPress・GA4・Search Console・Bing。その後、SNSや動画媒体も追加できるような、拡張可能な土台を目指しています。
「記事No」で派生コンテンツをつなげる
特に重要だと考えているのが、媒体をまたいだコンテンツ同士の関係です。
例えば記事No.0065から、Pinterest画像、X投稿、ショート動画5本を作ったとします。
それぞれの数字を保存するだけでは、媒体別の集計で終わってしまいます。
そこで、
記事 → SNS投稿・動画 → UTM → ブログ流入 → サイト内行動
という関係を後から追えるようにします。
記事No、投稿ID、UTMパラメータなどを使い、「どの記事から何が派生したのか」をデータ上でもつなげる考え方です。
一方、記事とは関係なく作ったSNS投稿や、紐付けられない流入もあります。それらを無理に記事へ結び付けず、独立したデータとして残せる構造も必要です。
現在値ではなく「変化」を残したい
AI分析を考えるうえでは、現在の数字だけでは不十分だと考えています。
例えば検索表示回数が1,000回あっても、
最初から伸びていたのか、最近急に伸びたのか、少しずつ成長したのか、現在は失速しているのかで意味が違います。
だからこそ、**「今いくつか」だけでなく「どう変化したか」**を残したいと思っています。
過去のデータを時系列で保存しておけば、後から分析方法が変わっても別の角度から検証できます。
単なる最新数値の一覧ではなく、メディア運営の履歴をデータとして残すことが重要になります。
最終的にはAIへ「次に何をするか」を聞きたい
この仕組みの目的は、大きなダッシュボードを作ることではありません。
最終的にはAIへ、
「直近30日で伸びているテーマは?」
「GoogleとYouTubeの両方で反応が良いテーマは?」
「表示回数は増えたのにCTRが低い記事は?」
「次に深掘りする記事候補は?」
と質問できる状態を目指しています。
さらに将来は、人間から質問しなくても、AI側から変化を見つけて改善候補を提示できれば理想です。
AIを単なる文章生成ツールではなく、自分の運営データを読み続ける分析担当者として使うイメージです。
まとめ
全媒体データ分析基盤を作り始めた理由は、単純に数字を一画面へまとめたいからではありません。
ブログ、検索、SNS、動画へ発信先が広がるほど、コンテンツ同士はつながっているのにデータは分散していきます。
そこで、
データを自動取得する → 共通ルールで保存する → コンテンツ同士をつなぐ → 時系列で蓄積する → AIが横断分析する
という土台を作ることにしました。
生成AIが今後さらに進化しても、自分自身の過去データがなければ、得られるのは一般論が中心です。
だからこそ、AIが将来分析できる材料を今から残しておく。
まだ開発の入口ですが、システムを実際に作りながら、失敗や設計変更も含めて記録していきたいと思います。