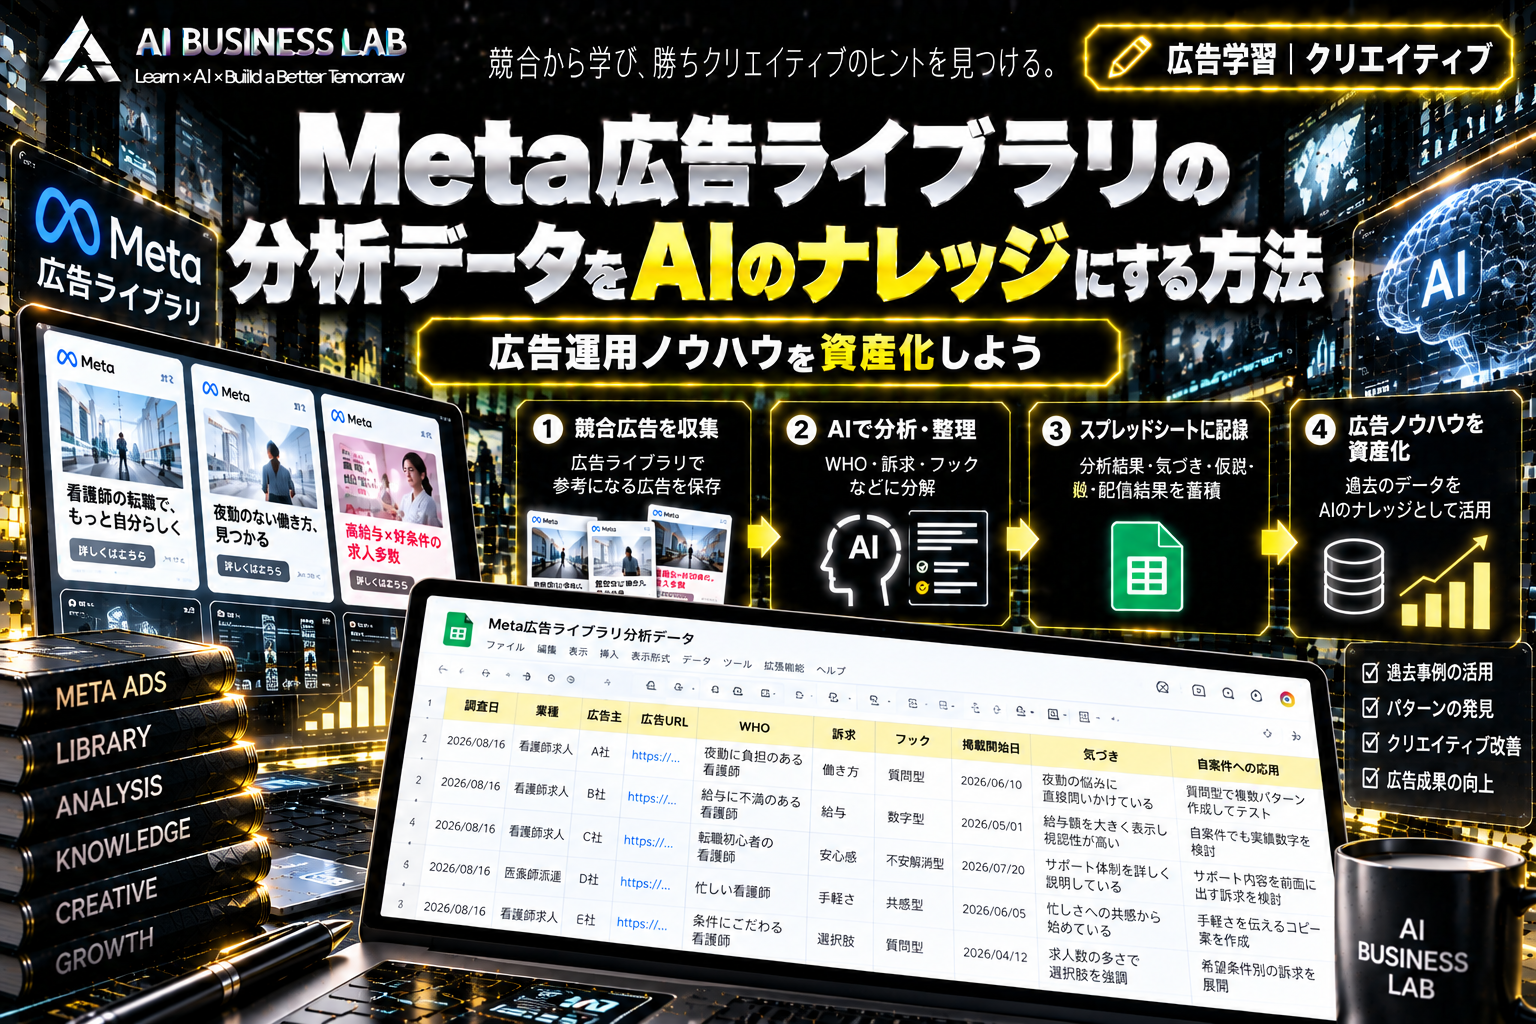
Meta広告ライブラリで競合広告を調べると、WHO・訴求・フックなど、広告制作に役立つ情報が得られます。
しかし、調査した内容をその場限りで終わらせてしまうと、次の案件で同じような調査を繰り返すことになるかもしれません。
そこで考えたいのが、競合調査から広告制作、実際の配信結果、改善内容までを記録し、AIが参照できるナレッジとして蓄積する方法です。
AIに毎回ゼロから広告案を考えてもらうのではなく、自分が調査・実践してきた情報を材料として活用します。
今回は、広告運用の経験を将来も利用できる知識として残すための基本的な考え方を整理します。
この記事で分かること
- 広告運用でAIナレッジを蓄積する意味
- 競合情報・仮説・実績を区別する方法
- 広告制作から改善までの記録項目
- スプレッドシートでの管理方法
- 蓄積したデータをAIへ活用する考え方
AIの広告分析は「渡す情報」によって変わる
生成AIに「看護師求人の広告訴求を10案考えて」と依頼すれば、給与、働き方、安心感など、さまざまな候補を作れます。
しかし、AIが自分の過去の広告運用を自動的に把握しているわけではありません。
例えば、過去の配信結果として「質問型フックはCTRが高かったものの、CVにはつながりにくかった」という情報があれば、新しい広告案を考える際の参考になります。
もちろん、過去の結果が別の案件でも再現されるとは限りません。
それでも、一般的な広告知識だけで考える場合と、自分の実績も参照する場合では、検討できる材料が異なります。
そのためには、AIへ渡せる形で広告運用の情報を残しておくことが必要です。
最初のナレッジは競合広告の調査結果
ナレッジ作りの入口になるのが、Meta広告ライブラリでの競合調査です。
例えば看護師求人の広告について、WHO・訴求・フック・ビジュアル・CTA・掲載開始日などを記録します。
さらに「給与数字を大きく見せている」「働き方について質問するフックを使っている」といった気づきも残します。
ここで重要なのは、確認できた事実と自分の推測を区別することです。
| 情報の種類 | 記録例 |
|---|---|
| 確認できた事実 | 競合A社が働き方をテーマにした広告を掲載していた |
| 分析・推測 | 夜勤に負担を感じる看護師を狙っている可能性がある |
| 自分の仮説 | 働き方への質問型フックは反応を得られるのではないか |
競合広告が長期間掲載されていても、成果が良いとは断定できません。
AIが後から参照するときにも、事実と仮説を混同しないように記録します。
競合調査から作った広告仮説を残す
競合広告を分析したら、自案件で試したい広告仮説を考えます。
例えば「夜勤や勤務時間に悩む看護師には、働き方の選択肢を伝える広告が反応されるのではないか」という仮説です。
この段階では、まだ実際の成果は分かりません。
それでも、なぜその仮説を考えたのかを記録しておけば、後から配信結果と照らし合わせられます。
競合広告だけを保存すると「市場で何を見たか」が残ります。
そこに自分の仮説を加えることで、市場を見て何を考えたのかまで残せます。
実際に制作・出稿した広告も記録する
仮説を作ったら、実際のクリエイティブへ落とし込みます。
例えば、WHOは「夜勤に負担を感じる看護師」、訴求は「働き方の選択肢」、フックは「現在の勤務環境について問いかける質問型」とします。
このとき、完成した広告画像だけでなく、採用した訴求や制作意図も記録します。
また、広告ごとに管理IDを付けておくと便利です。
例えば一つの仮説から、質問型のAD-0001、悩み提示型のAD-0002、選択肢提示型のAD-0003を制作したとします。
それぞれの広告と元の仮説を関連付けておけば、後から「どの考え方をもとに制作した広告なのか」を確認できます。
配信結果は実測データとして保存する
広告を配信したら、広告費、表示回数、CTR、CPC、CV、CPAなどを記録します。
ここで初めて、自分の案件に対する実際の反応を確認できます。
ただし、数字を保存する際は、集計期間や広告費、配信条件も残しておくことが重要です。
例えばCTRが高くても、表示回数が少なければ結果が偶然変動している可能性があります。
また、CVが発生していない広告ではCPAを計算できません。
数値だけを並べるのではなく、どの条件で得られた結果なのかを後から確認できる状態にします。
結果への考察と改善内容も残す
広告運用のナレッジでは、結果だけでなく、その後の判断も重要です。
例えば、ある広告でCTRは高かったものの、CVRが低かったとします。
その結果から「広告で期待させた内容とLPの訴求にズレがあるのではないか」と考えたなら、その考察を残します。
ただし、これは原因が確定したわけではありません。
配信結果は実測値、原因についての考察は仮説として区別します。
その後、広告本文をLPの内容に合わせて修正したなら、変更内容と変更日を記録します。
改善後の結果も残せば、次のような履歴になります。
競合調査 → 仮説 → 出稿 → 結果 → 考察 → 改善 → 再検証
この一連の流れが、次の広告制作で参照できる実践記録になります。
成功だけでなく失敗もナレッジにする
広告ナレッジには、成果が良かった広告だけを残す必要はありません。
例えば、手軽さを訴求した広告が期待した結果につながらなかった場合も、その記録は参考になります。
将来、似た広告案を考える際に、過去の結果や当時の考察を確認できるからです。
ただし、一度成果が悪かった訴求を、今後すべての案件で使えないと判断するのは早計です。
ターゲット、LP、配信条件などによって結果は変わります。
失敗事例も「何を、どの条件で試し、どうなったのか」という形で残すことが大切です。
スプレッドシートで構造化して管理する
最初から複雑なデータベースを作る必要はありません。
Googleスプレッドシートでも、基本的な情報を整理できます。
例えば、次のような項目を用意します。
| 項目 | 内容 |
|---|---|
| 広告ID | 広告を識別する番号 |
| 参考広告・仮説 | 何を参考に、何を試そうとしたか |
| WHO・訴求・フック | 広告設計の内容 |
| 出稿情報 | 広告画像、LP、配信期間 |
| 配信結果 | 広告費、CTR、CPC、CV、CPAなど |
| 考察 | 結果について考えたこと |
| 改善内容 | 実際に変更したこと |
| 再検証結果 | 改善後の数値と判断 |
データが増えたら、競合広告、広告仮説、出稿広告、配信結果を別々のシートに分け、IDで関連付ける方法もあります。
重要なのは、後から「なぜ作った広告なのか」「どのような結果になったのか」を追えることです。
蓄積したナレッジをAIに活用する
データが蓄積されれば、AIへの質問も変わってきます。
例えば「看護師求人の広告案を考えて」ではなく、「過去の看護師求人広告の配信結果を確認し、今回試す価値がありそうな訴求を3つ提案して」と依頼できます。
さらに、過去の失敗事例との比較や、まだ試していない訴求の抽出にも活用できます。
ただし、スプレッドシートに保存しただけで、AIが自動的に内容を覚えるわけではありません。
AIにファイルを渡す、必要なデータを読み込ませる、検索できる仕組みと接続するなどの工程が必要です。
また、過去の数値から得られた傾向と、AIが新たに推測した内容は区別して確認します。
まとめ|広告運用の経験を次回も使える情報にする
Meta広告ライブラリの調査結果は、広告制作の参考になる情報です。
そこに自分の仮説、実際の出稿内容、配信結果、考察、改善履歴を加えることで、広告運用のナレッジへ発展させられます。
大切なのは、データを大量に集めることだけではありません。
何を参考にし、なぜその広告を作り、どのような結果になり、次に何を変えたのか。
この流れを記録しておくことです。
そして、確認できた事実、実測データ、自分の仮説を区別して保存します。
将来的には、蓄積した情報をAIへ渡し、過去の事例を参考にしながら新しい広告仮説を検討できます。
広告運用を繰り返すほど、次の判断に使える材料が増えていく。
その仕組みを作ることが、広告運用ノウハウをAIのナレッジとして蓄積する目的です。