ブログ記事からショート動画を自動生成するシステムを作り、Ver.1として一通りの製造ラインを動かせるところまで進みました。
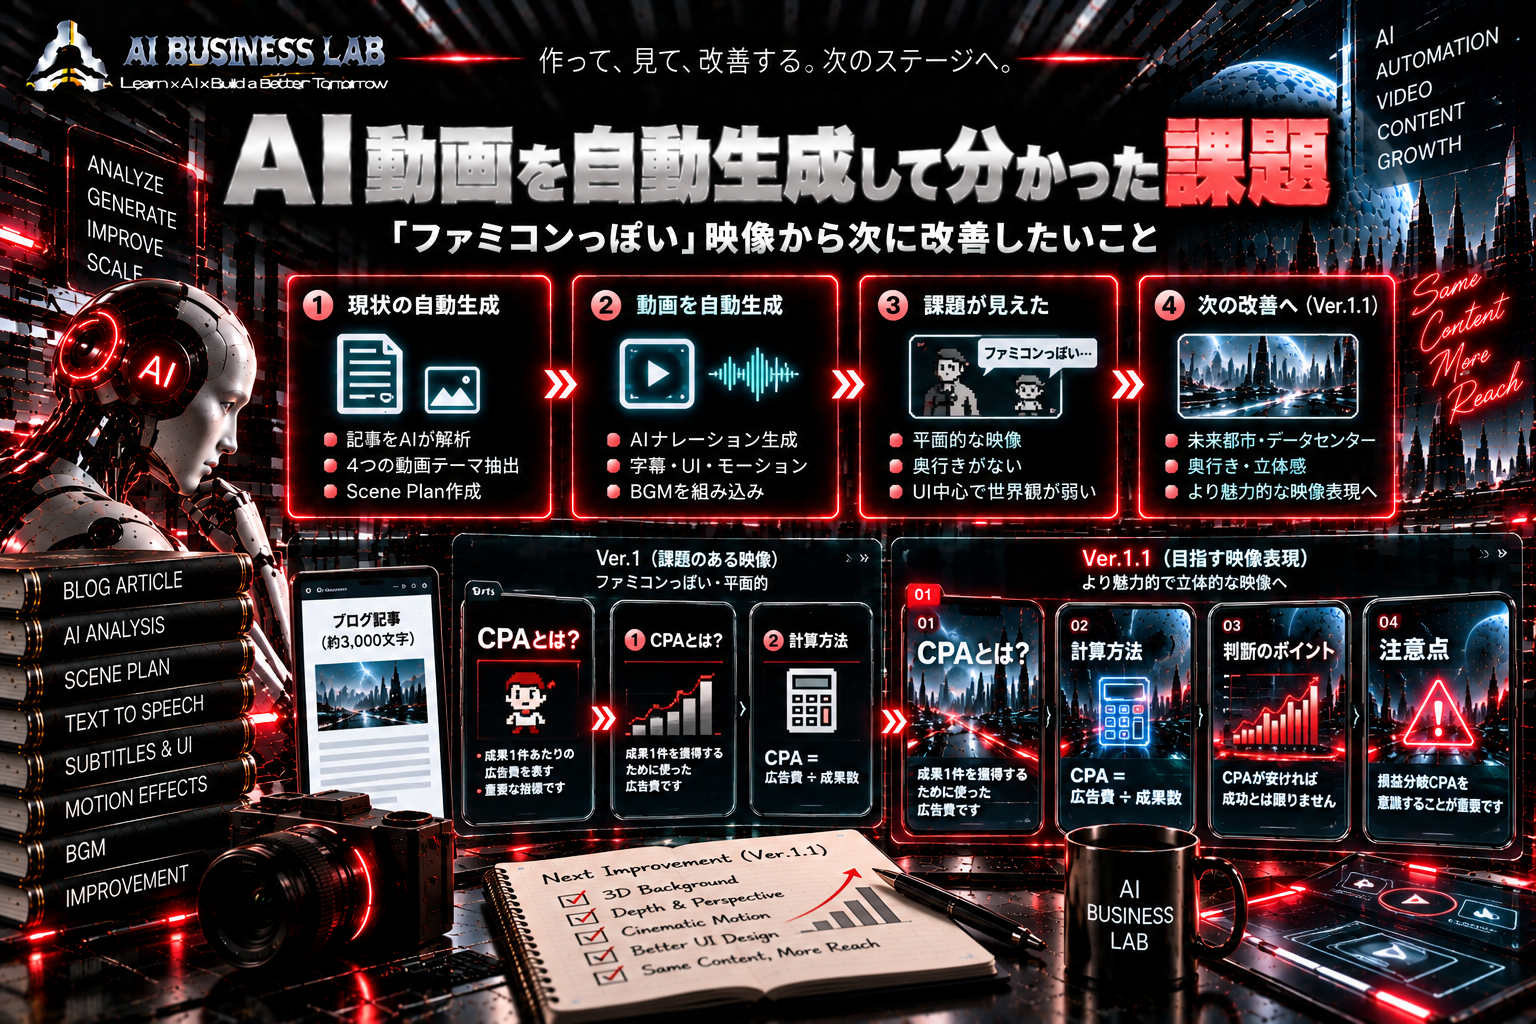
記事をAIが解析し、1記事から4つの動画テーマを抽出。Scene Planを作り、AIナレーションを生成し、Pythonで字幕・UI・モーション・BGMを組み合わせて1080×1920pxの動画として出力する。
実際に4本のショート動画まで完成し、技術面では大きく前進しました。
ところが、完成した動画を見て最初に感じたのは、
「なんだかファミコンっぽい……」
という違和感でした。
もちろん本当に昔のゲーム映像という意味ではありません。情報は整理され、字幕も画像も動いています。しかし、AI Business Labで目指している近未来的な世界観と比べると、どこか平面的でした。
今回は、実際に動画を作ったからこそ見えてきた課題と、次のVer.1.1で改善したい方向を整理します。
この記事で分かること
- AI動画生成Ver.1を作って見えた課題
- 「ファミコンっぽい」と感じた原因
- 派手さではなく奥行きを重視する理由
- Ver.1.1で改善したい映像表現
- Pythonによる自動生成を維持しながら品質を上げる考え方
「自動生成できる」と「見たい動画になる」は別だった
Ver.1では、まず記事を入力したら最後まで動画を生成できることを優先しました。
これは今でも正しかったと考えています。
最初から映像表現にこだわりすぎると、記事解析、Scene Plan、ナレーション、字幕、レンダリング、QAなど、システム全体がいつまでも完成しなかったかもしれません。
まず製造ラインを完成させ、実際に動画を作る。
そこまで到達したことで、今度は完成品そのものを評価できるようになりました。
そこで分かったのが、システムとして正常に動くことと、映像として魅力的であることは別の課題だということです。
なぜ「ファミコンっぽく」見えたのか
完成動画を確認すると、黒背景の上に情報カード、文字、アイコン、画像、アクセントラインなどが配置されています。
情報自体は整理されています。
しかし、ほとんどの要素が同じ平面上に置かれているように見えることに気づきました。
モーションについても、フェード、横移動、ズームなどが中心です。
つまり、
「情報は動いているけれど、空間は動いていない」
状態です。
これが、少し古いデジタル画面のように感じた大きな理由ではないかと考えました。
欲しいのは派手さではなく「奥行き」
ここでエフェクトや光を大量に追加すればよいわけではありません。
以前SFXを試したときも、字幕・UI・ナレーション・BGM・モーションに効果音まで加えると、情報系動画として少し騒がしく感じたため外しました。
今回も同じです。
必要なのは演出の量ではなく、画面に奥行きや空間を感じられることだと考えています。
そこでVer.1.1では、Renderer(映像を描画する部分)を中心に改善する方針にしました。
背景を「黒」から「未来空間」へ
現在の黒背景+UIという構成から、未来都市、データセンター、電子回路、光のラインなどを使った空間へ変えてみます。
ただし、未来都市の画像を背景へ一枚置くだけでは、結局は平面的です。
そこで、
手前=UIや字幕
中間=データパネルや構造物
奥=未来都市やデータセンター
というようにレイヤーを分けます。
各レイヤーを少し異なる速度で動かせば、パララックスのような疑似的な奥行きも表現できます。
特にデータセンターは、左右のサーバーラックと中央の通路によって自然な消失点を作れるため、AIやデータ分析を扱う動画との相性も良さそうです。
光にも遠近感を持たせたい
これまでのアクセントラインは、画面上に色の付いた線を表示する使い方が中心でした。
Ver.1.1では、光そのものにも質感を持たせたいと考えています。
中心を明るくして周囲をぼかす。移動後に残光を付ける。手前では太く、奥へ行くほど細くする。
こうしたルールを入れることで、単なる「赤い線」から、空間を走る光へ近づけられます。
同様にデータラインの間隔や移動速度にも遠近差を付ければ、2Dレンダリングでも疑似的な3D空間を表現できます。
「物体を動かす」から「カメラを動かす」へ
Ver.1では、文字やカード、画像などの物体を動かす発想が中心でした。
次は、カメラ自体が空間を移動しているように見せることも試したいと思っています。
未来都市へ近づく。
データセンターの通路を前進する。
光のラインを追いかける。
記事画像の全体から重要部分へ寄っていく。
実際に3D空間を作らなくても、拡大率、座標、レイヤー速度を組み合わせれば、ある程度のカメラワークは再現できます。
Python側にPERSPECTIVE_CITY、DATA_CENTER、LIGHT_TUNNELといった背景テンプレートを用意し、AIがScene Planから選択する形にすれば、これまでのAI=監督、Python=実行役という設計も維持できます。
世界観を強くしても情報を邪魔しない
ただし、映像を豪華にすることが目的ではありません。
今回作っているのは、短時間で情報を伝えるショート動画です。
そのため優先順位は、
情報理解 > 世界観 > 演出
と考えています。
背景が明るければ字幕部分を暗くする。重要な文字の周囲には余白を作る。背景と字幕を同時に激しく動かさない。ナレーションと表示内容を一致させる。
こうした基本はVer.1.1でも維持します。
Ver.1は残してRendererだけを育てる
今回の改善では、システム全体を作り直すつもりはありません。
Ver.1ですでに、記事入力、4テーマ抽出、Scene Plan、AIナレーション、実音声尺の測定、字幕、UI、BGM、QAなどの流れは動いています。
改善したいのは主に映像表現を担当するRendererです。
製造ラインはそのまま使い、同じScene Planから、より奥行きのある動画を生成できるようにする。
そのため、Ver.2ではなくまずVer.1.1として改善していくイメージです。
まとめ
AI動画生成システムVer.1では、記事から実際に4本のショート動画を生成するところまで進みました。
しかし完成したからこそ、
「情報は伝わるけれど、世界観がまだ弱い」
という次の課題が見えてきました。
自分が感じた「ファミコンっぽい」という違和感を分解すると、平面的な背景、UI中心の構成、弱い遠近感、単純なモーションなどが原因として見えてきます。
Ver.1.1では製造ラインを作り直すのではなく、未来都市、データセンター、発光するデータライン、レイヤー、遠近感、疑似カメラワークなどをRendererへ追加していきます。
まず動くものを作る。実際に見る。違和感を見つける。そして次のバージョンで改善する。
今回の「ファミコンっぽい」という感想も失敗ではなく、次に改善すべき場所を具体化するための検証結果になりました。
次は、情報が動くだけではなく、情報と光が未来空間を駆け抜けるような動画へ少しずつ近づけていきます。