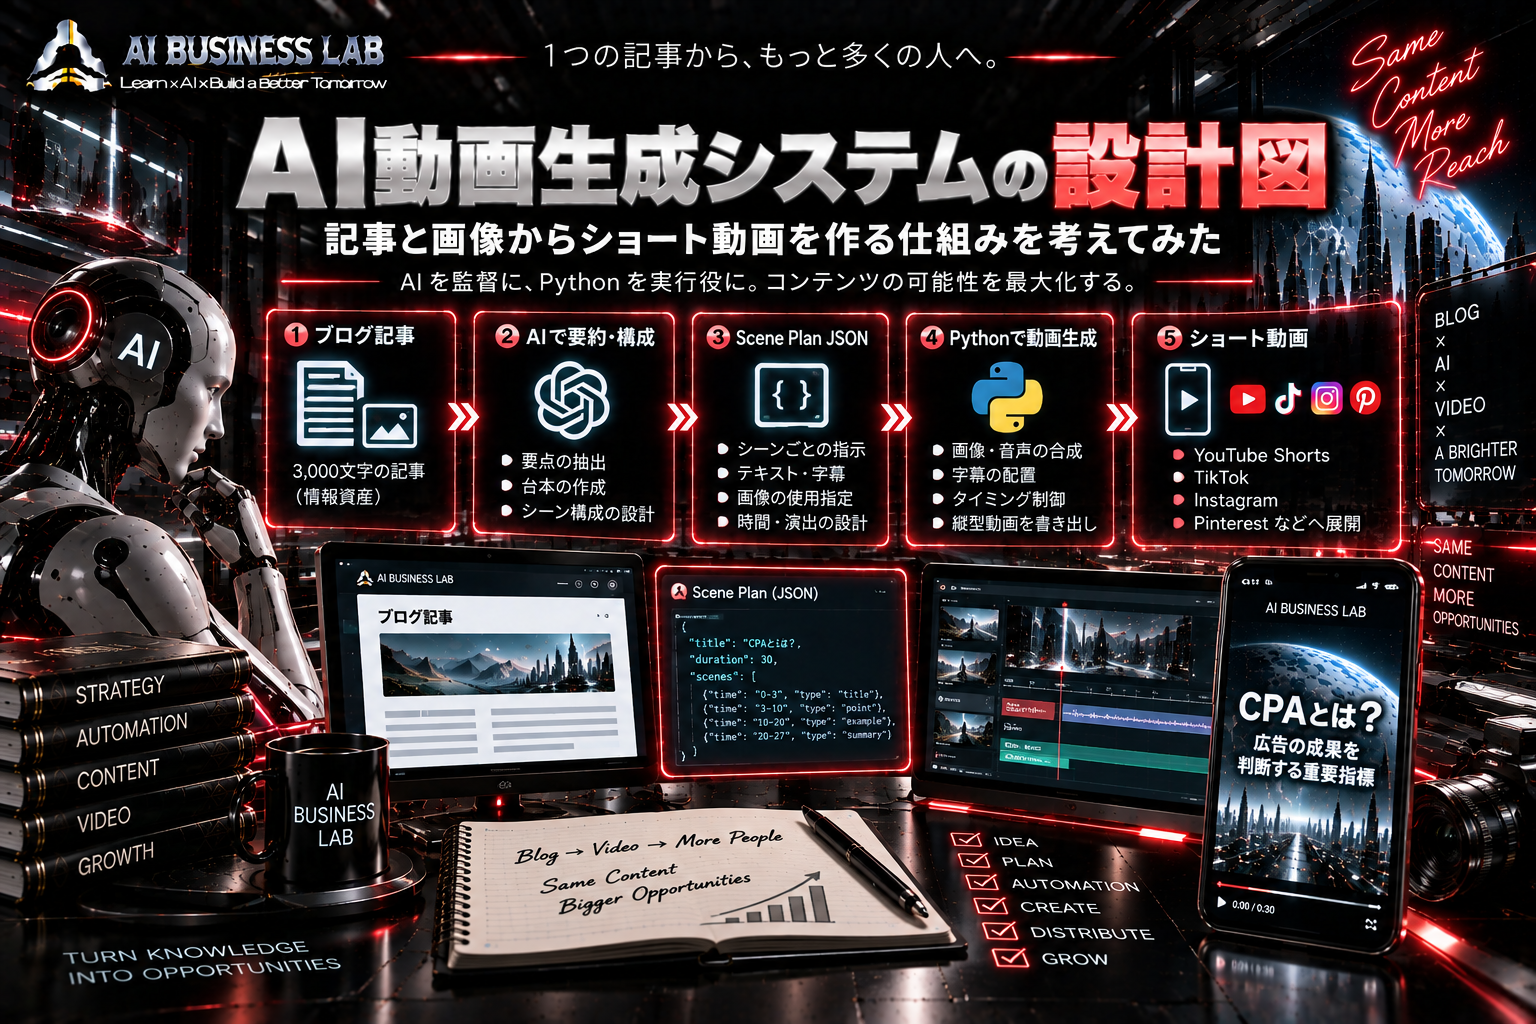
ブログ記事と画像からショート動画を自動生成する仕組みを考え始めた当初は、かなり単純に考えていました。
「記事をAIに渡して、そのまま動画を作ってもらえばよいのでは?」
しかし、継続的に何十本、何百本と動画を作ることを考えると、それだけでは安定しません。
AIは記事を理解して重要な情報を選ぶことは得意ですが、字幕の位置、表示時間、画像サイズなどを毎回同じルールで処理する仕事はプログラムの方が向いています。
そこで考えたのが、
AI=監督
Scene Plan JSON=設計図
Python=実行役
という3段階の構成です。
今回は、AI Business Labの記事と画像をショート動画へ変換するために考えた、動画生成システムの基本設計を整理します。
この記事で分かること
- AIとPythonを分ける理由
- Scene Plan JSONの役割
- 動画を一定品質で生成する考え方
- 記事・画像から動画が完成するまでの流れ
- 最初にどこまで自動化するのか
AIとPythonでは得意な仕事が違う
動画制作を分解すると、大きく2種類の仕事があります。
一つは、「何を伝えるか」を考える仕事です。
3,000文字の記事から重要なポイントを選び、30秒程度へ圧縮する。冒頭のフックを考え、どの順番なら初心者にも理解しやすいか判断する。
こうした意味を理解する仕事はAIに向いています。
もう一つが、**「決められた内容を正確に動画へする仕事」**です。
画像を配置する、字幕を表示する、指定時間で場面を切り替える、音声と映像を同期する、縦型動画として書き出す。
ルールが決まっている処理はPythonへ任せた方が再現しやすくなります。
そこで、AIを監督、Pythonを実行役として分離することにしました。
AIには完成動画ではなく「設計図」を作らせる
この仕組みで重要なのが、AIから直接完成動画を作ろうとしないことです。
まずAIが記事を読み、
「最初の3秒で何を伝えるか」
「次に何を説明するか」
「どこで具体例を入れるか」
「最後に何を残すか」
を決めます。
その結果をScene Planとして出力します。
Sceneは「場面」、Planは「計画」なので、動画を複数の場面に分けた設計図と考えると分かりやすいでしょう。
Scene Plan JSONでAIとPythonをつなぐ
Scene Planは、Pythonが読み取れるようJSON形式にします。
例えば簡略化すると、次のような情報です。
{
  "duration": 30,
  "scenes": [
    {
      "start": 0,
      "end": 3,
      "template": "TITLE",
      "headline": "CPAとは?"
    },
    {
      "start": 3,
      "end": 10,
      "template": "POINT",
      "headline": "成果1件を獲得する費用"
    }
  ]
}
普通の文章で「最初にタイトルを大きく出して、少し経ったら画像をズームする」とAIが指示しても、Pythonには「大きく」「少し」が分かりません。
開始時間、終了時間、テンプレート、見出しなどに分解すれば、Pythonは迷わず処理できます。
OpenAI APIには、指定したJSON Schemaに沿った構造でモデルの出力を扱うStructured Outputsの仕組みがあります。こうした構造化出力を使う考え方は、AIの判断を後続プログラムへ渡すシステムと相性があります。
デザインまでAIに自由に決めさせない
Scene Planには何でも書かせるわけではありません。
AIには、
何を伝えるか、何シーンにするか、どの順番にするか、どのテンプレートを使うか
を判断してもらいます。
一方、フォント、文字サイズ、字幕位置、余白、ロゴ位置、基本的なアニメーションなどはPython側で固定します。
例えば、
TITLE
POINT
EXAMPLE
COMPARISON
SUMMARY
という5種類のテンプレートを作っておきます。
AIは「ここは比較なのでCOMPARISON」と判断するだけです。実際の文字位置やサイズはPythonがテンプレートに従って描画します。
AIの自由度をあえて制限することで、動画ごとのデザインのブレを減らします。
PythonはScene Planを正確に再現する
Scene Planが完成したら、Pythonが設計図を読み込みます。
そこから、
素材を取得 → 画像を配置 → ナレーションを用意 → 字幕を描画 → シーンを切り替える → 音声と同期 → 動画を書き出す
という処理を実行します。
Pythonに「魅力的な動画にして」と考えさせる必要はありません。
動画の構成はAIが決め、Pythonは決められた設計をできるだけ正確に再現することへ集中させます。
同じ設計図なら同じ動画を作れる状態を目指す
今回特に重視したいのが、同じScene Planと同じ素材なら、基本的に同じ動画が完成する状態です。
タイトル位置、字幕サイズ、余白、切り替え方などが毎回変わってしまうと、量産するほど確認・修正作業が増えてしまいます。
単発のAI動画なら毎回違う演出も面白いですが、継続的な動画生成では、驚きより再現性と一定品質を優先したいと考えています。
記事とPinterest画像を素材層として使う
システム全体は、大きく3層に分けます。
素材層
:ブログ記事、タイトル、記事画像、Pinterest画像、記事No、URLなど
AI監督層
:記事理解、要点抽出、構成、ナレーション、Scene Plan生成
Python実行層
:画像・字幕・音声の配置、タイミング制御、レンダリング、動画出力
Pinterest画像も完成品をそのまま動画にするのではなく、拡大や移動などを加えられるビジュアル素材として扱います。
この3層を分けておけば、問題が起きた場所も特定しやすくなります。
内容がおかしければAI側、字幕位置がおかしければPython側、違う画像なら素材管理やScene Planを確認できます。
Scene Planを保存すると修正もしやすい
Scene Planをファイルとして残しておけば、動画を作り直すときにも便利です。
例えば字幕を大きくしたいだけなら、AIにもう一度記事を読ませる必要はありません。
Scene Planはそのまま使い、Python側の字幕設定を変更して再レンダリングできます。
逆に構成そのものを変えたい場合は、Scene Planだけを作り直します。
企画とレンダリングを分離することで、必要な部分だけ改善できるわけです。
最初は「安定した1本」を作る
将来的には、BGM選択、画像生成、SNS投稿、投稿後の分析まで自動化できるかもしれません。
ただし最初から全部は作りません。
まずは、
1記事+画像 → AIがScene Plan生成 → ナレーション生成 → Pythonで縦型動画化 → 人間が確認
という最小構成を作ります。
1本ができたら10本で試し、同じルールで安定して生成できるか確認します。
機能の多さより、繰り返しても壊れない基本構造を作ることを優先します。
まとめ
今回考えたAI動画生成システムでは、AIとPythonに同じ仕事をさせません。
AI=何を伝えるか考える監督
Scene Plan JSON=判断を構造化した設計図
Python=設計図を正確に動画へ変える実行役
という役割分担にします。
AIの柔軟な判断と、Pythonの再現性をScene Planでつなぐことで、
記事 → AIによる構成 → Scene Plan → 音声・字幕・画像 → Pythonレンダリング → ショート動画
という流れを作るのが基本設計です。
目指しているのは、AIが毎回違う派手な動画を作ることではありません。
記事を指定すれば、AI Business Labのルールに沿った動画候補を一定品質で繰り返し生成できること。
まずはその土台を作り、実際に動画を生成しながら少しずつ改善していく予定です。