ブログのSEOについて学んでいると、サイトマップやrobots.txtと一緒に出てくるのが**「noindex(ノーインデックス)」**です。
名前から何となく、
「Googleにインデックスさせない設定」
という意味は想像できます。
ただ、実際に使おうとすると、
「どんなページをnoindexにすればいいのか?」
「検索順位が低い記事はnoindexにした方がいいのか?」
「robots.txtとは何が違うのか?」
といった疑問が出てきます。
noindexは便利な仕組みですが、SEOに不要そうなページへ何となく設定するものではありません。
大切なのは、
「このURLをGoogle検索の入口として残す必要があるのか」
という視点です。
今回は、noindexの基本的な意味とrobots.txtとの違い、どのようなページで検討するのかを初心者向けに整理します。
この記事で分かること
- noindexとは何か
- robots.txtとの違い
- noindexを検討するページの考え方
- WordPressで設定するときの注意点
- アクセスが少ない記事へ安易に使わない方がよい理由
noindexとは?
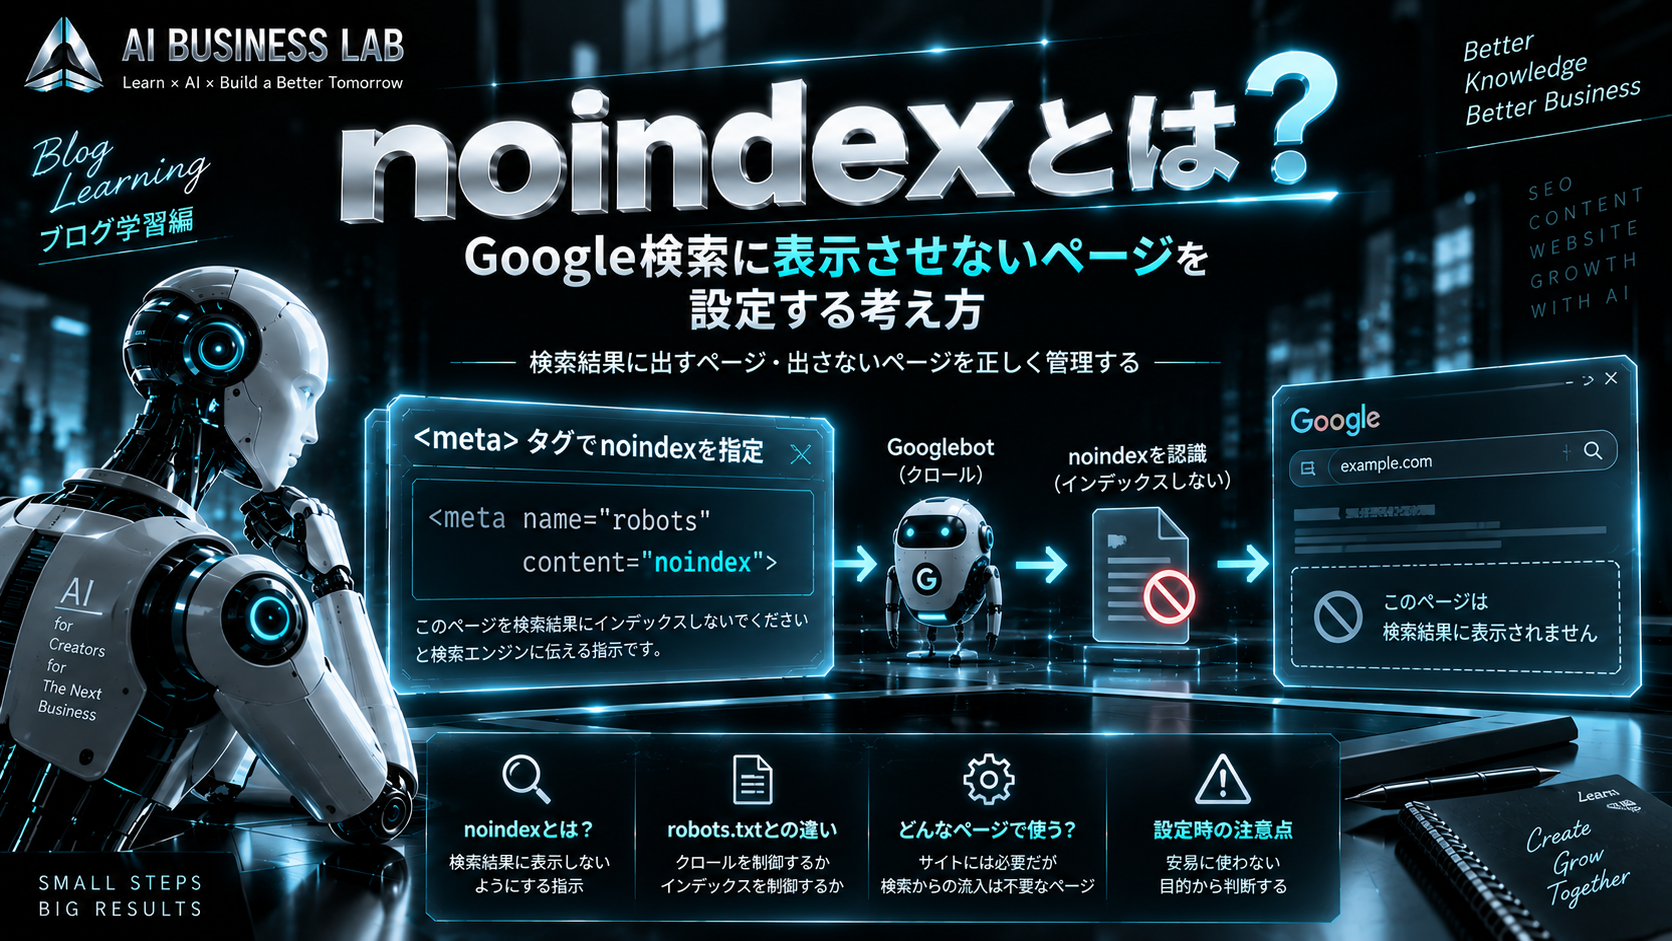
noindexとは、検索エンジンに対して、
「このページを検索結果へインデックスしないでください」
と伝えるための指示です。
HTMLでは、例えば次のような形で指定できます。
<meta name="robots" content="noindex">Googlebotがページをクロールしてnoindexを確認すると、そのページをGoogle検索結果へ掲載しないよう処理します。
すでに検索結果へ表示されているページでも、noindexを設定したあとGoogleが再クロールして指示を確認すれば、検索結果から外れていきます。
つまりnoindexは、ページ自体を削除する仕組みではなく、検索結果への掲載を制御する仕組みです。
URLへ直接アクセスすればページを見ることはできますし、SNSや広告、内部リンクからアクセスすることもできます。
noindexとrobots.txtは役割が違う
特に混同しやすいのがrobots.txtです。
違いを簡単に整理すると、
robots.txt=クロールを制御する
noindex=検索結果への掲載を制御する
となります。
Google検索では、大まかに、
URL発見 → クロール → 内容を処理 → インデックス → 検索結果への表示
という流れがあります。
robots.txtが主に関係するのは「クロール」の段階です。
一方noindexは、
「ページを確認しても構わないが、検索結果には出さないでほしい」
という指示です。
そのため、検索結果へ出したくないページをrobots.txtでブロックすればよい、というわけではありません。
robots.txtとnoindexを両方設定すればよいわけではない
ここは重要なポイントです。
検索結果へ表示したくないページだからといって、
robots.txtでクロールを禁止し、さらにnoindexも設定する
のが必ずしも正しいとは限りません。
Googleがnoindexを認識するには、ページへアクセスしてその指示を確認する必要があります。
ところがrobots.txtでクロールそのものをブロックすると、Googlebotがnoindexを確認できない可能性があります。
つまり、
クロールさせないこと
と、
検索結果へ出さないこと
は別々に考える必要があります。
「検索結果へ掲載させたくない」という目的なら、noindexをGoogleが確認できる状態にしておくことが基本です。
どんなページでnoindexを検討する?
noindexを検討しやすいのは、
「サイトには必要だが、Google検索から直接見つけてもらう必要はないページ」
です。
例えば、サイトによっては次のようなページが候補になります。
- フォーム送信後のサンクスページ
- 会員向けページ
- 検索流入を目的としない一時的なページ
- サイト内検索結果
- 広告専用として作ったページ
ただし、これらも一律にnoindexへすればよいわけではありません。
例えば広告用の記事LPであっても、検索ユーザーにとって役立つ情報があり、SEOからの流入も狙いたいのであればインデックスさせる考え方もあります。
判断基準はページの種類ではなく、
「このページをGoogle検索の入口としてユーザーへ提供したいか」
です。
カテゴリーやタグページは一律noindexにしなくてよい
WordPressでは、カテゴリー、タグ、著者アーカイブなどについてnoindex設定を見かけることがあります。
しかし、
「タグページだからnoindex」
のように一律で判断する必要はありません。
例えばカテゴリーページに記事が整理され、説明文もあり、読者が目的の記事を探しやすいなら、そのページ自体に検索結果から訪れてもらう価値があります。
反対に、ほとんど同じ内容のタグページが大量に作られている場合は、本当に検索結果へ残す必要があるのか検討する余地があります。
重要なのは、ページ形式ではなくそのURL単体に役割があるかです。
アクセスが少ない記事をすぐnoindexにしない
SEOでは、
「アクセスのない記事はnoindexにした方がよい」
という考え方を見かけることがあります。
しかし、
アクセスが少ない=不要な記事
とは限りません。
公開したばかりでまだ評価されていないだけかもしれませんし、検索需要そのものが少ないテーマかもしれません。
検索流入は少なくても、内部リンクから読まれて役立っている場合もあります。
そのため、
検索順位が低い
→アクセスが少ない
→noindex
と機械的に判断するのは避けた方がよいでしょう。
まずは、検索意図に合っているか、内容を改善できないか、他の記事と重複していないかを確認します。
そのうえで、
検索結果へ残す必要がない
と判断した場合にnoindexを検討する、という順番の方が自然です。
noindexはセキュリティ機能ではない
noindexを設定するとGoogle検索には表示されなくなりますが、ページそのものが非公開になるわけではありません。
URLを知っている人はアクセスできます。
そのため、
個人情報、社内資料、会員限定情報などを守るためにnoindexだけを使うのは適切ではありません。
本当に閲覧を制限したい情報には、ログイン認証やアクセス制御など別の仕組みが必要です。
検索結果へ出さないことと、ページを見られなくすることは別物
と覚えておきましょう。
WordPressでは設定ミスにも注意する
WordPressでは、テーマやSEOプラグインによって、投稿や固定ページへnoindexを設定できる場合があります。
簡単に変更できる反面、誤って通常の記事へnoindexを設定すると、その記事が検索結果へ表示されなくなる原因になります。
またWordPressには、サイト全体について検索エンジンへの表示を抑制する設定もあります。
ブログを公開したのに検索へ出てこない場合は、記事単体だけでなく、こうしたサイト全体の設定も確認する必要があります。
設定を変更した場合も、すぐ検索結果へ反映されるとは限りません。
Googleが再クロールして変更を認識するまで時間がかかることがあります。
まとめ|noindexは検索結果への掲載を管理する仕組み
noindexとは、
「このURLをGoogle検索結果へ表示しないでください」
と検索エンジンへ伝える仕組みです。
robots.txtがクロールを制御するのに対して、noindexは検索結果への掲載を制御します。
そして、noindexを使うときに最も大切なのは、
「SEOに弱そうだから外す」
という考え方ではなく、
「このページをGoogle検索の入口として残す必要があるか」
で判断することです。
検索ユーザーにも読んでほしいページなら、まず内容の改善を考える。
サイトには必要だが検索結果には不要なら、noindexを検討する。
不要なページそのものなら、削除や統合など別の方法も考える。
このようにページの役割から判断すると、noindexを無理に使う必要もなくなります。
noindexは検索順位を上げるための裏技ではなく、検索結果へ掲載するページと掲載しないページを整理するための技術的な仕組みとして理解しておくとよいでしょう。
※本記事は2026年9月時点のGoogleの公開情報をもとに整理しています。仕様は変更される可能性があるため、最新情報はGoogle公式情報をご確認ください。