ブログのSEOについて勉強していると、**「robots.txt(ロボッツ・テキスト)」**という言葉が出てきます。
サイトマップやクロール、インデックスなどと一緒に登場するため、
「robots.txtを設定するとSEOに強くなるのか?」
「検索結果に出したくないページを指定するもの?」
「noindexとは何が違うのか?」
と混乱しやすいところです。
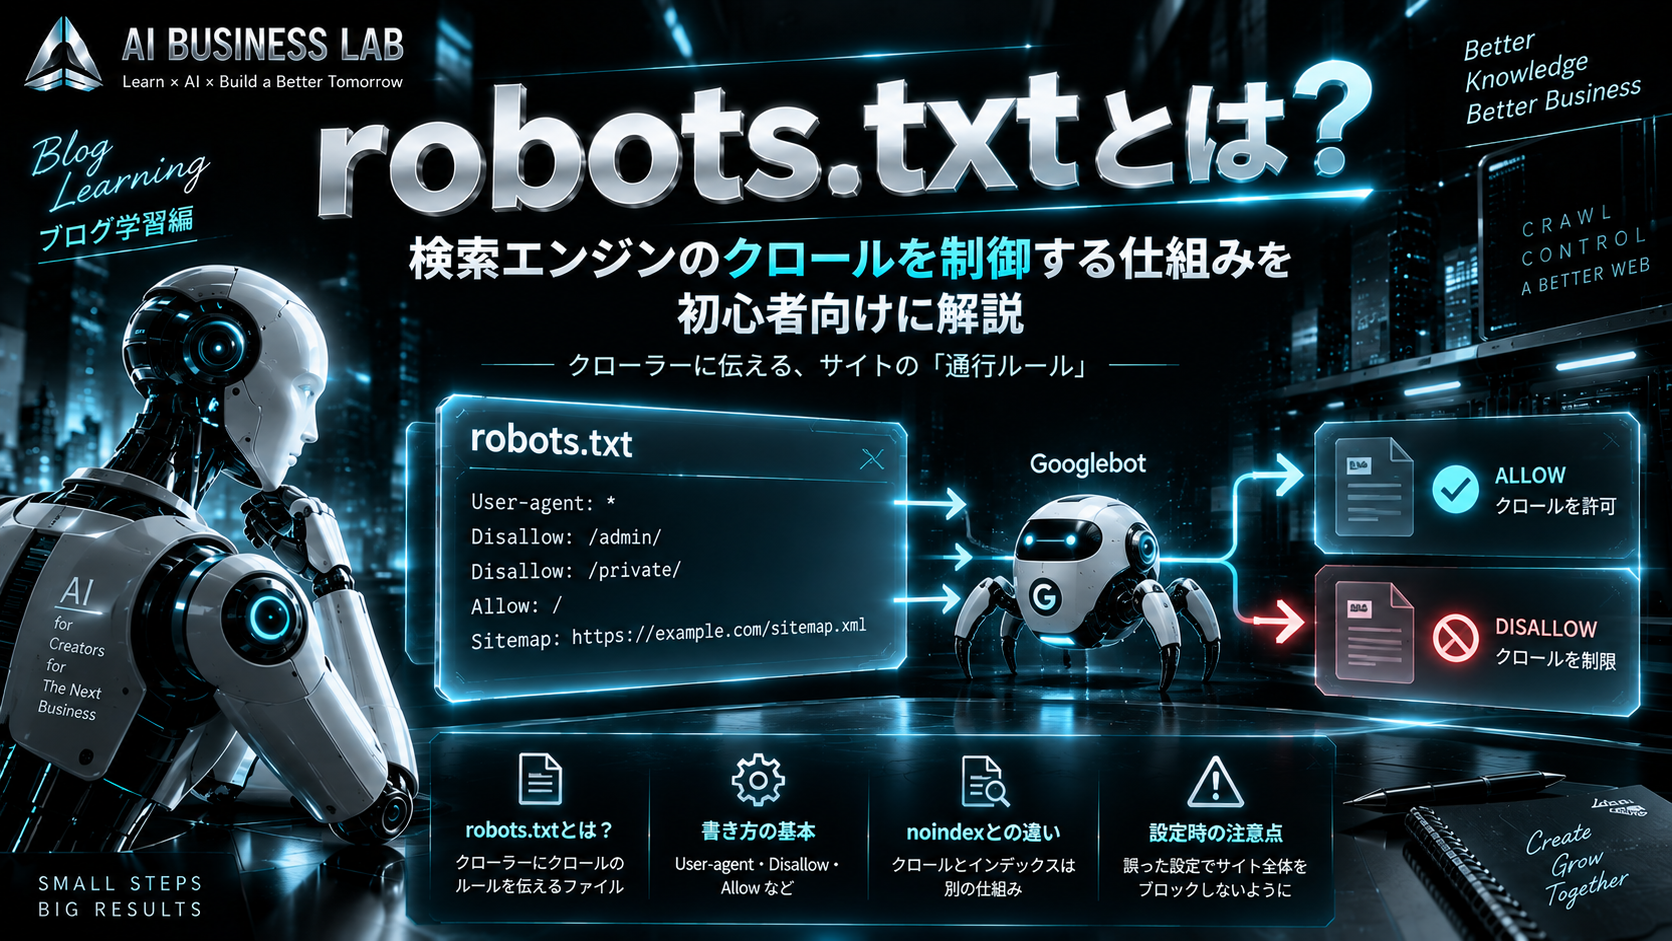
robots.txtを簡単に言えば、検索エンジンのクローラーに対して、サイト内のどこをクロールしてよいか・してほしくないかを伝えるファイルです。
ここで重要なのは、robots.txtが主に制御するのは**「クロール」であり、「インデックス」を禁止するための仕組みではない**ことです。
今回はrobots.txtとは何なのか、その役割と基本的な仕組み、特に間違えやすいnoindexとの違いを中心に整理します。
この記事で分かること
- robots.txtとは何か
- robots.txtで何を制御できるのか
- robots.txtとnoindexの違い
- robots.txtを使う際の注意点
- WordPressブログでどう考えればよいか
robots.txtとは?
robots.txtは、Googlebotなどのクローラーに対して、サイト内のURLをクロールできるかどうかを伝えるためのテキストファイルです。
通常はWebサイトのルートに配置されます。
例えばサイトURLが、
であれば、
https://example.com/robots.txt
という場所です。
Googlebotなどのクローラーはrobots.txtを確認し、記載されたルールに従ってサイトをクロールします。
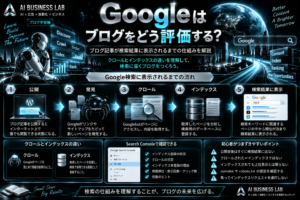
ブログ記事がGoogle検索に表示されるまでには、大まかに、
URLを発見 → クロール → 内容を処理 → インデックス → 検索結果への表示
という流れがあります。
robots.txtが関係するのは、この中のクロールです。
robots.txtには何が書かれている?
robots.txtでは、対象となるクローラーと、クロールを制御したい場所を指定します。
例えば、次のような記述です。
User-agent: *
Disallow: /example/User-agentは対象となるクローラーを指定する項目です。
*は、ルールの対象となるすべてのクローラーを意味します。
Disallowはクロールしてほしくないパスを指定します。
この例では、対象となるクローラーに対して、
「/example/以下をクロールしないでください」
と伝えています。
Googleはrobots.txtでallowやdisallowなどのルールをサポートしています。
ただし、初心者がSEO目的で細かな設定を覚える必要はありません。まずはrobots.txtがクローラーのアクセス範囲を伝えるものと理解しておけば十分です。
robots.txtは検索順位を上げるものではない
robots.txtという技術的な設定を見ると、
「細かく設定すればSEOに強くなるのでは?」
と思うかもしれません。
しかし、robots.txtは検索順位を直接上げるための設定ではありません。
本来の目的は、クローラーによるアクセスを管理することです。
例えば、サイト内にクローラーがアクセスする必要のない領域や、大量のURLが生成される仕組みがある場合などにクロールを制御することがあります。
そのため、一般的な小規模WordPressブログで、robots.txtを細かく編集すること自体をSEO対策の中心にする必要はありません。
むしろ、意味を理解せず変更すると、本来Googleに見てもらいたい記事までクロールできなくなる可能性があります。
robots.txtとnoindexの違い
robots.txtを理解するときに最も重要なのが、noindexとの違いです。
大まかに整理すると、
robots.txt
=クローラーにページをクロールしないよう伝える
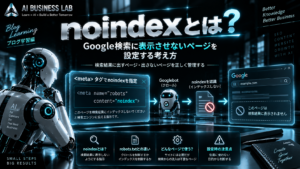
noindex
=ページを検索結果へインデックスしないよう伝える
という違いがあります。
つまり、
クロールさせたくない
のか、
検索結果へ表示させたくない
のかによって目的が異なります。
Googleも、Google検索へのインデックスを防ぐ方法としてrobots.txtを利用することは推奨していません。
ここを理解せず、
「Google検索に出したくないからrobots.txtでブロックしよう」
と考えると、目的と手段がずれてしまいます。
robots.txtでブロックしても検索結果に出ることがある
「クロールを禁止すれば検索結果にも出ないのでは?」と思うところですが、必ずしもそうではありません。
Googleは、robots.txtでクロールをブロックしたページでも、他のページからリンクされているなどの理由によってURL自体を認識することがあります。
その結果、ページ内容をクロールしていなくても、URLなどが検索結果へ表示される可能性があります。
つまり、
クロールを防ぐこと=インデックスを確実に防ぐこと
ではありません。
これがrobots.txtとnoindexを分けて考える必要がある大きな理由です。
noindexとrobots.txtを両方設定すれば安心?
ここでも注意が必要です。
検索結果へ表示したくないページにnoindexを設定すると、Googlebotがページをクロールした際にその指示を確認できます。
ところが同じページをrobots.txtでクロールできない状態にすると、Googlebotがページへアクセスできず、noindex自体を確認できない可能性があります。
そのため、
「検索に出したくないからrobots.txtとnoindexを両方設定しておけば安心」
とは限りません。
検索結果へのインデックスを防ぎたいのであれば、Googleがnoindexを確認できる状態にしておく必要があります。
robots.txtとnoindexは、強弱の違う同じ機能ではなく、そもそもの役割が違う仕組みとして理解することが重要です。
robots.txtはセキュリティ機能でもない
もう一つ覚えておきたいのが、robots.txtは機密情報を隠すための仕組みではないという点です。
robots.txt自体は公開されており、ブラウザから誰でも確認できます。
例えば、
Disallow: /secret/と記載すれば、むしろ/secret/という場所が存在することを外部から確認できます。
また、robots.txtは対応するクローラーへ「クロールしないでください」と伝える仕組みであり、人間によるアクセスを禁止するものでもありません。
非公開情報や会員限定ページなどを保護するのであれば、認証など別のアクセス制御が必要です。
robots.txt=アクセス禁止のセキュリティ設定
と考えないようにしましょう。
設定ミスでサイト全体をブロックすることもある
robots.txtでは、設定内容によっては重要なページまでクロールできなくなる可能性があります。
代表的なのが、
User-agent: *
Disallow: /
という記述です。
/はサイト全体を示すため、これは対象となるクローラーへサイト全体をクロールしないよう伝える設定になります。
開発中の環境などで意図的に使われる場合もありますが、公開中のブログへ誤って設定すれば問題になります。
そのため、ネット上で見つけたrobots.txtの設定を、意味を理解せずそのままコピーするのは避けた方がよいでしょう。
WordPress初心者は積極的に変更する必要がある?
一般的なWordPressブログであれば、SEO対策としてrobots.txtを積極的にカスタマイズする必要は通常ありません。
まず大切なのは、
robots.txtが何をしているのか理解し、必要なページを誤ってブロックしないこと
です。
もし記事がGoogleにクロールされない場合は、すぐrobots.txtを書き換えるのではなく、Google Search ConsoleのURL検査などから現在の状態を確認します。
そこでクロールが許可されているかなどを確認し、robots.txtが原因だと分かってから設定を見直す方が安全です。
robots.txtは「設定すればSEOが強くなるもの」ではなく、クロールを制御する明確な理由があるときに使うものと考えておくとよいでしょう。
まとめ|robots.txtはクローラー向けの通行ルール
robots.txtは、Googlebotなどのクローラーに対して、サイト内のどこをクロールしてよいか・してほしくないかを伝えるファイルです。
イメージとしては、Webサイト内を巡回するクローラーへ示す**「通行ルール」**に近いものです。
そして最も重要なのが、
robots.txtはクロールを制御するものであり、インデックスを禁止する仕組みではない
という違いです。
検索結果へ表示したくないページにはnoindexなど、目的に合った方法を使う必要があります。
また、robots.txtは機密情報を守るセキュリティ機能でもありません。
一般的なWordPressブログでは、細かなrobots.txt設定をSEO対策として積極的に変更するより、役割を正しく理解し、必要なページを誤ってブロックしないことの方が重要です。
クロールとインデックスを別の段階として理解すると、robots.txtが何を制御しているのかも分かりやすくなります。
※本記事は2026年9月時点のGoogleの公開情報をもとに整理しています。仕様は変更される可能性があるため、最新情報はGoogle公式情報をご確認ください。