ブログ記事と画像を再利用してショート動画を自動生成する。その基本設計として、前回は、
AI=監督
Scene Plan JSON=設計図
Python=実行役
という役割分担を考えました。
ただし、設計だけでは動画は完成しません。Pythonを動かす環境を整え、記事や画像を読み込み、AIへ渡せるところまで実装する必要があります。
そこで今回は、OpenAIのコーディングエージェント「Codex」を使い、実際の動画生成システム構築を始めました。Codexはコード生成だけでなく、機能実装やリファクタリングなど、実際の開発作業を進められるコーディングエージェントです。(OpenAI)
今回は動画そのものではなく、「動画を作る工場をどう作り始めたか」を整理します。
この記事で分かること
- Codexをシステム開発に使う理由
- Python環境とフォルダ構成の考え方
- AI解析前に入力検証が必要な理由
- 記事と画像をAIへ渡す仕組み
- AIとPythonの役割を分ける考え方
Codexで実装することにした理由
今回の目的は、Pythonのコードを自分ですべて書くことではありません。
作りたいのは、記事資産をショート動画へ変換する仕組みです。
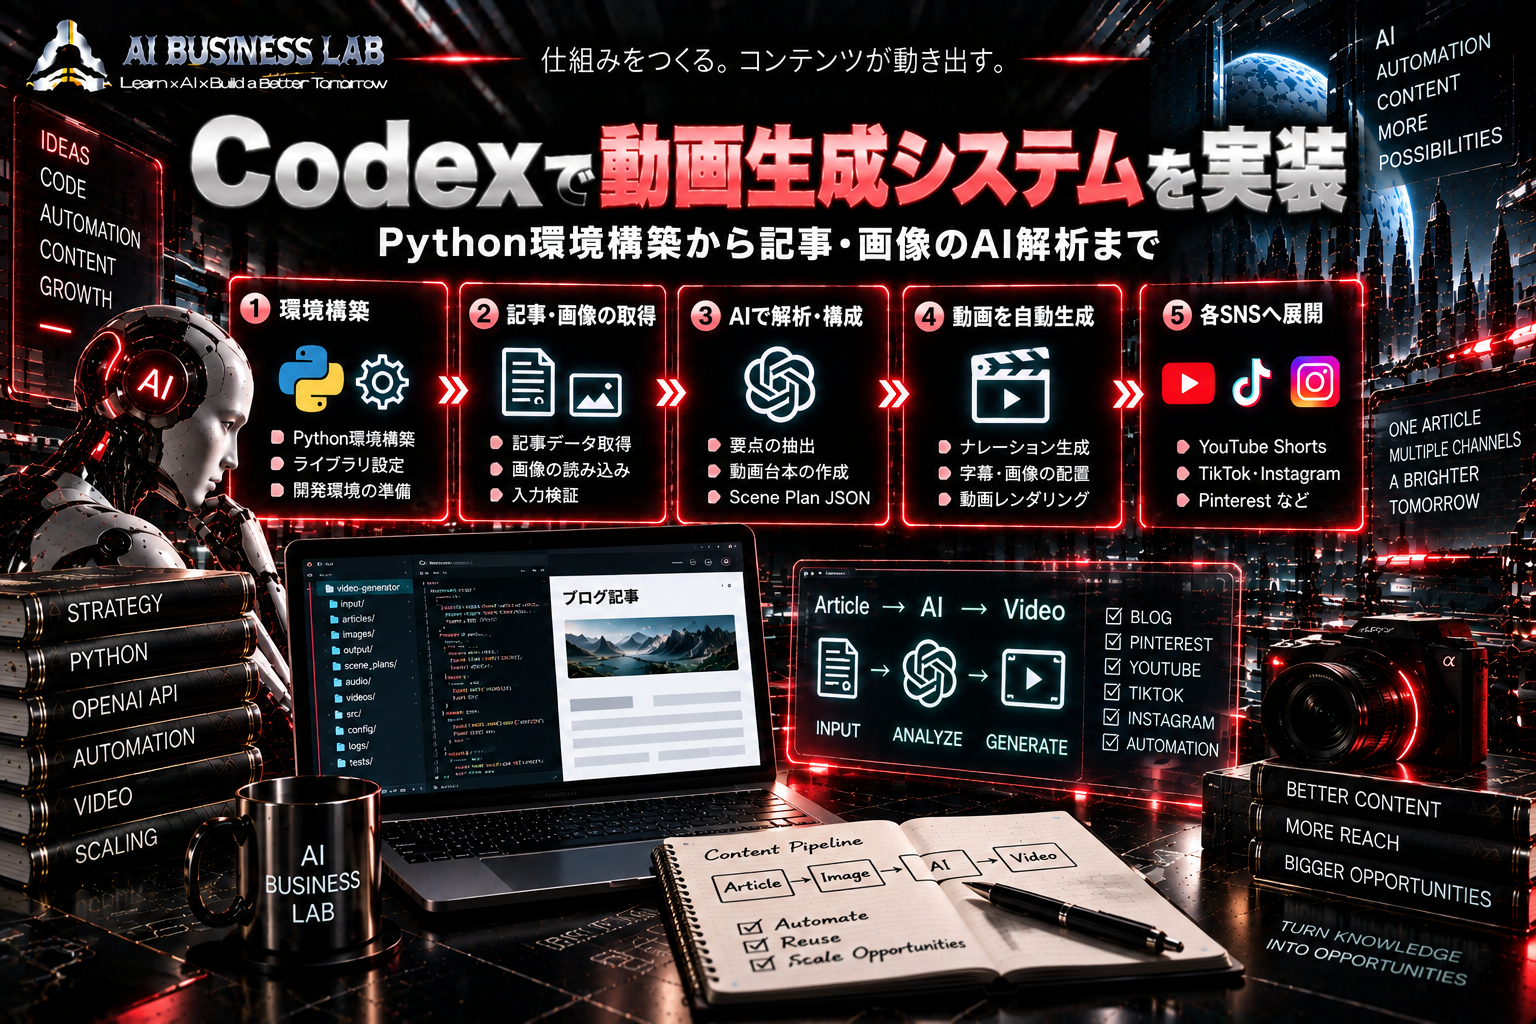
記事を取得する、対応画像を探す、AIへ渡す、Scene Planを作る、音声や字幕を生成する、最後に動画として書き出す。
こうした複数の機能を組み合わせる必要があります。
そこで、人間側では「システムをどう動かしたいか」を設計し、その仕様をCodexへ渡して実装を進める方法を選びました。
コードそのものより、目的・入力・処理・出力をどう設計するかへ集中するためです。
まずPythonを安定して動かせる環境を作る
動画生成システムだからといって、最初から動画生成には入りません。
まずPythonの実行環境を用意し、必要なライブラリやAPI設定を整えます。
同時に重要だと感じたのがフォルダ構成です。
例えば、
video-generator/
├── input/
│   ├── articles/
│   └── images/
├── output/
│   ├── scene_plans/
│   ├── audio/
│   └── videos/
├── src/
├── config/
├── logs/
└── tests/
というように、元データ、生成物、プログラム、設定、ログ、テストを分けます。
小さなプログラムなら一つのフォルダでも動きますが、動画・音声・JSONなどが増えると管理しにくくなります。
最初から整理しておくことで、後から機能を追加しやすくします。
AIを呼び出す前に「入力検証」をする
次に実装したいのが入力検証です。
例えば、
「記事No.0085を動画化する」
と指定しても、記事ファイルがない、対応画像がない、本文が空、画像が壊れている、といった可能性があります。
この状態でAI解析へ進んでも正常な結果は期待できません。
そこでPython側で、
記事が存在するか → 本文を取得できるか → 対応画像があるか → 画像を開けるか
といった機械的な確認を先に行います。
問題があれば、そこで停止します。
APIを使う前に材料を確認することで、無駄な処理を減らし、エラー原因も追いやすくなります。
OpenAI APIで記事と画像を解析する
入力を確認できたら、OpenAI APIへ接続します。
Responses APIではテキストだけでなく画像も入力として扱えるため、記事本文と記事画像を材料としてモデルに渡す構成が可能です。(OpenAI Developers)
ここでは、
「この記事で最も重要な内容は何か」
「30秒なら何を残すか」
「どんなシーン構成にするか」
といった、意味を理解しなければ判断できない部分をAIへ任せます。
今回の構想では、その監督役としてGPT-5.6 Terraを使うことを考えています。TerraはOpenAIが知能とコストのバランスを取ったモデルとして位置付けており、APIモデルIDは gpt-5.6-terra です。(OpenAI Developers)
動画を継続的に生成するなら、性能だけでなくAPIコストも含めてモデルを選ぶ必要があります。
画像も動画設計の材料にする
記事本文だけでなく、すでに作成した記事画像やPinterest画像も利用します。
画像にはタイトルや図解だけでなく、記事ごとのアクセントカラーや世界観も含まれています。
例えば黒背景に赤が使われている記事なら、動画側でも赤をアクセントとして引き継げれば、元記事との統一感を作れます。
ただし色の取得まで毎回AIへ任せる必要はありません。
画像データから色を抽出し、黒・白・グレーなどを除外したうえで、彩度や使用量からアクセントカラー候補を選ぶ処理はPythonでも実装できます。
意味の判断はAI、数値として処理できるものはPython。
ここでも役割を分けます。
AIの解析結果をScene Plan JSONへ変換する
記事と画像を解析した結果は、自由な文章ではなくScene Plan JSONへ変換します。
例えば、動画タイトル、アクセントカラー、動画時間、各シーンの種類、見出し、ナレーション、使用画像などを構造化して保存します。
OpenAI APIには、指定したJSON Schemaに沿った出力を生成するStructured Outputsがあります。Scene Planのように後続プログラムで処理するデータでは、この仕組みを利用することで構造を安定させやすくなります。(OpenAI Developers)
つまり、
記事・画像 → AI解析 → Scene Plan JSON → Python
とつなぎます。
AIが考えた内容を、人間がコピーしてPythonへ渡す必要をなくすことが目的です。
Codexでは一気に完成させず段階的に作る
今回のシステムでは、Codexに最初から「全部作って」と依頼するのではなく、機能を分割して実装します。
Python環境を整える。フォルダ構成を作る。入力検証を作る。APIへ接続する。記事解析を試す。画像解析を追加する。Scene Planを生成する。
一つずつ動作を確認してから次へ進みます。
特に自動化では、1回動いたことより、何度実行しても同じ条件で安定して動くことが重要です。
正常な記事だけでなく、画像がない場合や入力がおかしい場合もテストし、少しずつ壊れにくい仕組みにしていきます。
まとめ
今回の段階では、まだ完成したショート動画を量産できる状態ではありません。
作っているのは、その前段階となる動画生成工場の基礎部分です。
基本的な流れは、
記事・画像 → Pythonで入力検証 → AIで内容解析 → Scene Plan JSON → Pythonで動画生成
となります。
Codexには、この設計を実際に動くPythonコードへ落とし込む役割を任せます。
そして重要なのは、何でもAIへ任せないことです。
記事を理解して構成を考える仕事はAI。ファイル確認、色の数値処理、配置、出力など再現性が必要な仕事はPython。その実装をCodexと進める。
まずは記事と画像を正しく読み込み、AIが動画設計に必要な情報を返せるところまで作る。その土台が安定してから、音声、字幕、レンダリングへ進めていく予定です。