ブログやSNSの運営データを一か所へ集め、将来的にAIで分析する「全媒体データ分析基盤」を作っています。
WordPress、GA4、Google Search Console、Bing、YouTubeなどからPythonでデータを取得し、SQLiteへ保存するところまで進めてきました。
そこで気付いたのが、数字を集めるだけではAI分析の準備は終わらないということです。
例えば「0」という数字。本当に実績が0だったのか、データを取得できなかったのかでは意味がまったく違います。
今回は、AIへブログデータを渡す前に決めた「数字の意味を壊さないためのルール」を整理します。
この記事で分かること
- 0とNULLを区別する理由
- FLOWとSNAPSHOTの違い
- API取得値と計算値を分ける理由
- resolved/unresolvedの考え方
- AIによる誤分析を防ぐための分析ルール
0とNULLは同じではない
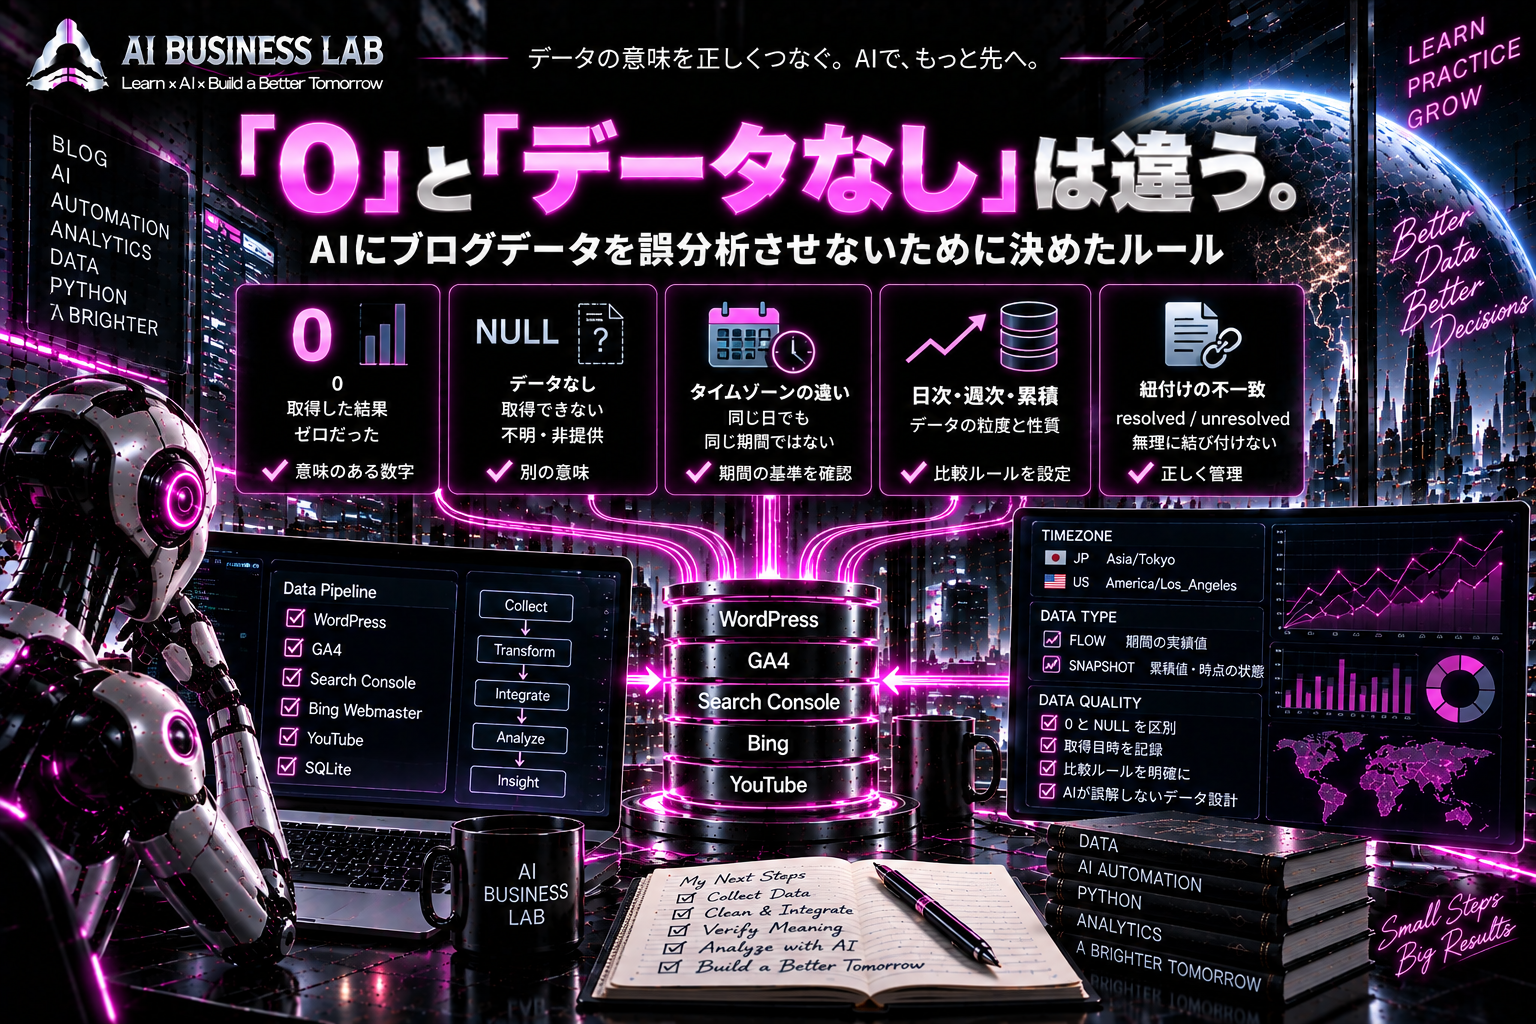
最初に決めたのが、0とNULLを明確に区別することです。
例えばSearch Consoleから正常にデータを取得し、クリック数が0だった場合は「対象期間にクリックされなかった」という観測結果です。
一方、APIの取得に失敗してクリック数が分からなかった場合、そこへ0を入れてしまうと意味が変わります。
今回の基盤では、
0=取得した結果、本当にゼロだった
NULL=不明・未取得・非提供など、値が存在しない
として扱います。
さらに「レコードそのものがない」状態も別です。そもそも取得処理をしていない可能性があるためです。
AIに「この動画は再生数0なので反応がありません」と分析されても、実際には動画自体を投稿していなかったのでは意味が違います。
分からないものを0で埋めない。
これはデータ分析基盤を作るうえで重要なルールになりました。
FLOWとSNAPSHOTを区別する
数字には性質の違いもあります。
今回の設計では、主にFLOWとSNAPSHOTを区別します。
FLOWは、一定期間に発生した量です。
例えば「9月1日のクリック数」「9月1日のセッション数」などが該当します。
一方、SNAPSHOTは、ある時点で観測した状態や累積値です。
YouTubeの累積再生数が、
9月1日時点:1,000回
9月2日時点:1,200回
だった場合、合計して2,200回とはしません。
分かるのは、2つの時点の差が200回だったということです。
累積値を日次実績と同じように扱えば、AIが誤った集計をする原因になります。
そのため、数字だけでなく「どのような性質の数字なのか」も保存するようにします。
APIが返した数字と計算した数字も分ける
もう一つ区別したいのが、API報告値とシステム側で計算した派生値です。
例えばSearch Consoleから、
表示回数:1,000
クリック数:50
を取得すれば、CTRは5%と計算できます。
ただし、この5%がAPIから直接取得した値なのか、自分のシステムで計算した値なのかは分けておいた方が安全です。
YouTubeでも、累積再生数が10,000回から10,500回へ増えた場合、差分500回は計算できます。
しかしこれは「YouTube APIがその期間の再生数を500回と報告した」という意味とは限りません。
観測された事実と、そこから計算した結果を混同しない。
AIがデータの根拠まで正しく判断するために必要な考え方です。
分からない紐付けはunresolvedのまま残す
複数媒体を統合すると、「この数字はどの記事のものなのか」という問題も発生します。
例えばGA4から取得したURLを記事マスタと照合し、記事Noまで特定できれば**resolved(解決済み)**です。
しかしURL変更やパラメータなどが原因で、自動的に記事を特定できないこともあります。
この場合は**unresolved(未解決)**として残します。
無理に「おそらくこの記事だろう」と結び付けません。
未解決データを保存しておけば、後からURL正規化やURL履歴などの仕組みを改善したとき、改めて紐付けられる可能性があります。
分からないものを、分かったことにしない。
0とNULLの区別にも通じる考え方です。
完了していない期間を比較しない
日付が付いていても、その期間が完成しているとは限りません。
例えば9月10日の昼に当日のGA4データを取得し、9月9日の1日分と比較して「アクセスが50%減った」と判断するのは適切ではありません。
9月10日はまだ途中だからです。
そこで分析時には、complete period(対象期間が完了しているか)も確認します。
また、APIから正常に取得できたからといって、その媒体側で数値が確定しているとも限りません。後から集計結果が更新されるサービスもあります。
そのため「対象期間」と「取得日時」も分けて記録しておく必要があります。
データの粒度が違えば単純に比較しない
ブログ分析では、記事単位、SNS投稿単位、日次、週次など、さまざまな粒度のデータを扱います。
ここにも落とし穴があります。
例えば一つの記事からSNS投稿を5件作り、その記事にGA4で100セッションがあったとします。
記事IDだけで両方を単純にJOINすると、100セッションが5投稿それぞれに付与され、合計500のように見える場合があります。
APIの数字は正しくても、データの結合方法によって数字が壊れるわけです。
そのため、まず同じ粒度で集計し、その後に比較する必要があります。
AIへ渡す前に「分析契約」を作る
こうした問題を整理した結果、SQLiteのデータをそのままAIへ渡すのではなく、分析契約を設けることにしました。
例えば、0とNULL、FLOWとSNAPSHOT、指標の単位、API報告値と派生値、resolved/unresolved、タイムゾーン、期間完成の有無、比較可能な粒度などです。
つまりAIに「自由に分析してください」と渡すのではなく、
「この数字は何を意味し、どの条件なら比較してよいのか」
まで一緒に定義します。
高性能なAIでも、入力データの意味が間違っていれば正しい分析はできません。むしろ自然な文章で、説得力のある誤分析を作ってしまう可能性があります。
まとめ
全媒体データ分析基盤を作り始めた当初は、多くの媒体から数字を自動取得することを重視していました。
しかし実際に統合してみると、重要なのは数字の量だけではありません。
0なのか不明なのか。
期間実績なのか累積値なのか。
APIが報告した値なのか計算値なのか。
記事との関係を確認できたのか。
比較できる期間・粒度なのか。
こうした意味を失わずに保存することが必要です。
AIに誤分析させないためには、AIの性能を上げる前に、数字に嘘をつかせないデータ構造を作ることが重要だと分かってきました。
全媒体データ分析基盤も、単に数字を集める仕組みから、少しずつ「AIが正しく判断するためのデータを作る仕組み」へ変わってきています。