ブログの記事が増え、Google検索だけでなくYouTubeやSNSにも展開するようになると、運営データが複数のサービスへ分散していきます。
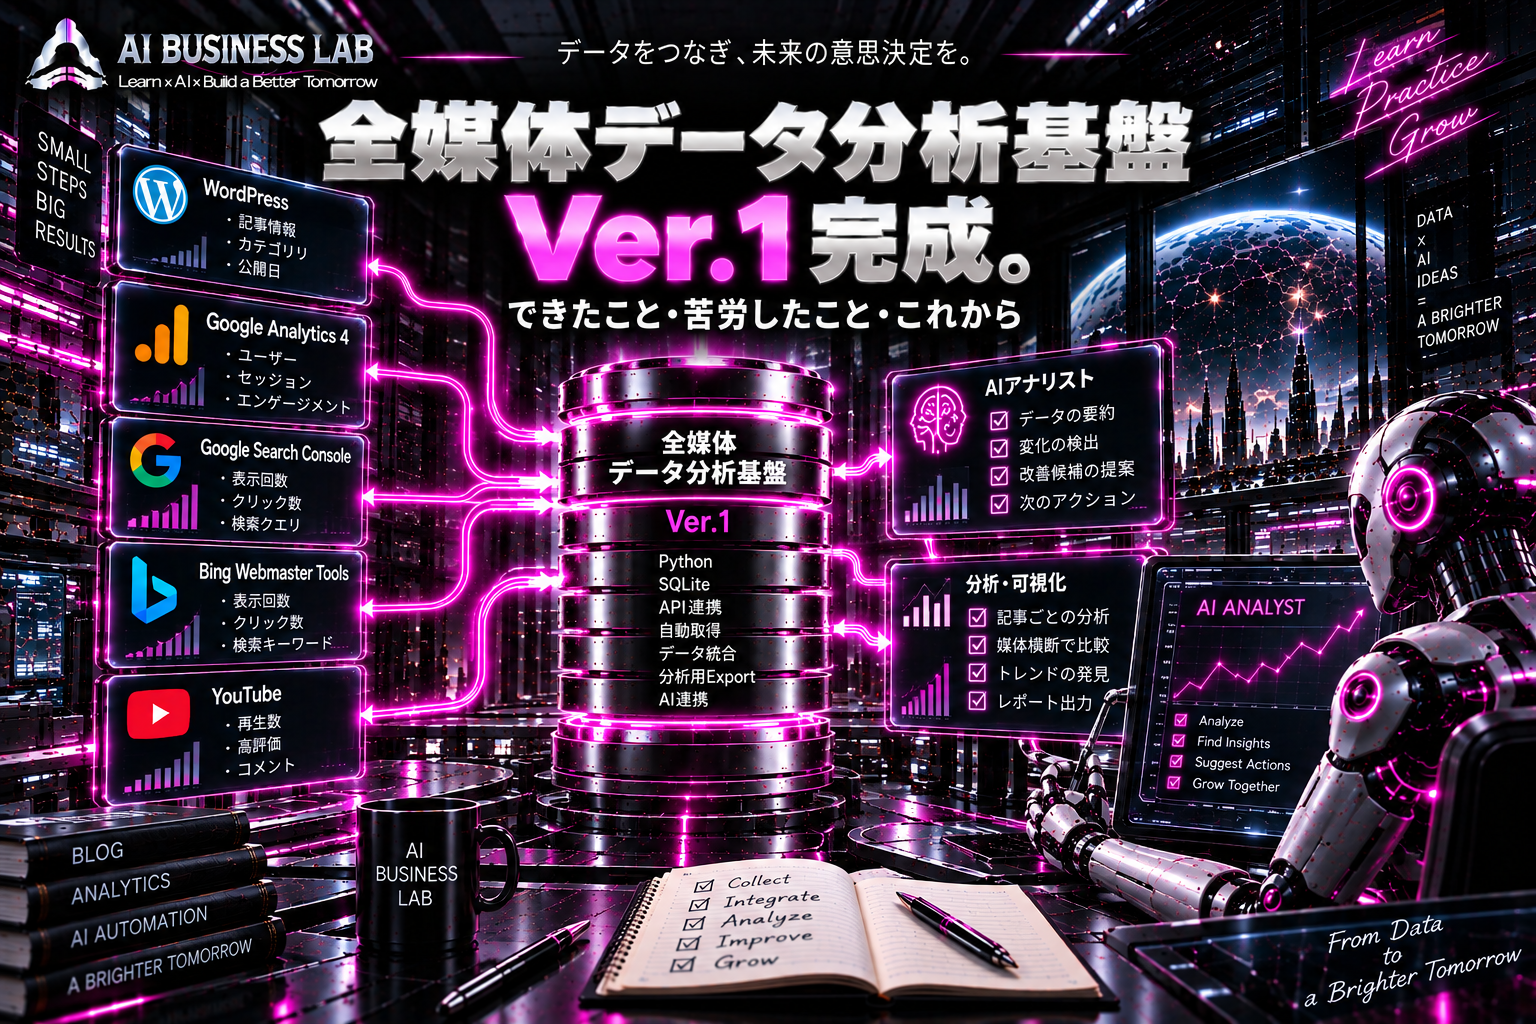
WordPressには記事情報、GA4にはアクセスデータ、Search ConsoleにはGoogle検索、Bingには別の検索データ、YouTubeには動画のデータがあります。
それぞれ確認することはできますが、知りたいのは最終的に、「どの記事が、どの媒体で、どのように伸びているのか」です。
そこでCodexを使いながら、PythonとSQLiteを中心とした「全媒体データ分析基盤」を作ってきました。
認証やAPI連携、データ構造の見直しなどで何度も詰まりましたが、ひとまずVer.1と呼べるところまで完成しました。
今回は、Ver.1で何ができるようになったのか、実際に苦労したこと、そして今後どこへ発展させるのかを整理します。
この記事で分かること
- 全媒体データ分析基盤Ver.1で実装したこと
- Codexを使った開発で苦労したポイント
- AI分析の前にデータ設計が必要だった理由
- Ver.2以降に追加したい機能
最初はWordPressの記事管理から始まった
最初から大きな分析システムを作ろうとしていたわけではありません。
当初はGoogle Apps Scriptとスプレッドシートを使い、WordPressの記事タイトルやURL、公開日などを自動取得することから始めました。
ところがGA4、Search Console、Bing、YouTubeと対象を広げるにつれて、単純な表だけでは管理しにくくなりました。
一つの記事から複数のSNS投稿や動画が生まれ、そこからブログへの流入も発生します。
そこで途中から、Pythonでデータを取得し、SQLiteで関係性を持って保存する仕組みへ発展させました。
Ver.1で5つのデータ源を接続
Ver.1では、主に次の5つを扱えるようにしました。
WordPress、GA4、Google Search Console、Bing Webmaster Tools、YouTubeです。
WordPressの記事情報を基準に、GA4のアクセス、Google・Bingの検索、YouTubeの動画データを蓄積します。
ここで重要になったのが、WordPress投稿IDとは別に作った**「記事No」**です。
例えば「0065」という記事Noを固定しておけば、タイトルやURLが変わっても同じコンテンツとして管理できます。
将来的には、
記事No → 検索 → GA4 → YouTube → SNS投稿 → UTM → ブログ流入
という関係を追える状態を目指しています。
苦労したのはAPI接続だけではなかった
開発前は「APIさえ接続できれば、あとは数字を保存すればよい」と考えていました。
実際には、Google OAuth、GCP、各APIの有効化、アカウント権限、YouTubeのチャンネル設定、Bing側の設定など、コード以外の確認事項がかなりあります。
特に印象に残ったのがYouTubeです。
API自体は正常に動いているのに、取得したかったチャンネルとは別のチャンネル情報が返ってくることがありました。
ここで、「エラーが出ない=正しいデータが取れている」ではないと分かりました。
認証成功だけでなく、「誰の、どのデータを取得したのか」まで確認する必要があります。
数字を保存するだけでは分析できなかった
さらに難しかったのが、取得後のデータ設計です。
例えばGA4とSearch Consoleでは、日付の扱いをそのまま同一視できません。Bingでは週単位のデータを考慮する必要があり、YouTubeには累積値として取得する指標もあります。
そこでVer.1では、単なる数値だけでなく、
期間・タイムゾーン・データ粒度・取得日時・指標の性質
なども意識して保存・分析する設計にしました。
また、
0=取得した結果、本当にゼロだった
NULL=不明、未取得、非提供など
として区別します。
期間内に発生した数値を「FLOW」、ある時点の累積状態を「SNAPSHOT」として分ける考え方も取り入れました。
AIに分析させるなら、数字を大量に集めること以上に、数字の意味を壊さず保存することが重要だったからです。
AIのために「分析契約」を作った
こうした問題を整理する中で作ったのが「分析契約」です。
これは、AIがデータを分析するときに守るルールです。
例えば、NULLを0として扱わない、FLOWとSNAPSHOTを単純合計しない、週次データを勝手に日次へ分割しない、未完了期間を完了期間と比較しない、といったルールを定めます。
高性能なAIでも、入力データの意味が間違っていれば、もっともらしい誤分析を作る可能性があります。
そのため、AIに何を分析させるかだけでなく、何をしてはいけないかも先に決めることにしました。
分析用ExportとAI-ready packageも作成
Ver.1ではSQLiteへ保存して終わりではなく、分析に使いやすい形へ変換する分析用Exportも用意しました。
さらに、その先のAI分析を想定したAI-ready packageも作っています。
AIへデータベース全体をそのまま渡すのではなく、「今週伸びた記事は?」という質問なら、その分析に必要な期間・記事・検索・アクセスデータと注意事項をまとめて渡す仕組みです。
データの期間や指標、制約を説明するmanifestも持たせ、数字と一緒に「数字の取扱説明書」をAIへ渡すことを意識しています。
毎朝8時の自動同期まで実装
Ver.1では、毎朝8時にデータを自動同期するところまで進めました。
これによって、毎回手動でPythonを実行しなくても履歴が蓄積していきます。
分析基盤では、1日だけ正しく取得できることより、同じルールで継続してデータが積み上がることが重要です。
7日、30日と蓄積すれば、現在値だけでなく「最近伸び始めた記事」も見つけられるようになります。
Codexは開発を進める大きな助けになった
今回Codexは、Pythonコードの作成だけでなく、既存コードの確認、SQLiteの変更、テスト、APIエラーの調査、修正と再検証などにも使いました。
自分だけで一からコードを書いていたら、ここまで対象を広げるにはもっと時間がかかったと思います。
一方で、Codexがあれば設計まで任せきれるわけではありません。
何を分析したいのか、数字をどう解釈するのか、どこまでAIに任せるのか。
この部分は人間側で考える必要がありました。
次はSNSと「変化」の分析へ
Ver.1は完成しましたが、分析基盤としてはスタート地点です。
次はPinterestやInstagramなどのSNSデータを追加し、記事NoやUTMを使って、SNS投稿からブログ流入までつなげたいと考えています。
データが蓄積した後は、7日・30日のtrend分析や、通常と異なる変化を見つけるanomaly検出へ進む予定です。
最終的にはAIへ、
「今週伸び始めた記事は?」
「次に確認すべき記事は?」
「検索とSNSで反応が違うテーマは?」
と質問し、根拠となるデータとともに候補を出してもらうことを目指します。
まとめ
今回、Codexと作ってきた全媒体データ分析基盤が、ひとまずVer.1まで到達しました。
WordPress、GA4、Search Console、Bing、YouTubeをPythonで取得し、SQLiteへ蓄積。記事Noによる紐付け、分析ルール、Export、AI-ready package、毎朝の自動同期まで一通り形になりました。
実際に作ってみて分かったのは、AI分析システムを作るとき、AIより先にデータの土台が必要だったということです。
Ver.1はAIアナリストの完成ではありません。
正しいデータを継続して蓄積し、将来AIに分析してもらうための最初の基盤です。
ここから実際の運営データをためながら、SNS連携、trend分析、異常検出、AI分析へと少しずつ育てていきます。