ブログの数値を自動で集めたいと考えたとき、最初に選んだのはGoogle Apps Script(GAS)+Googleスプレッドシートでした。
WordPressの記事情報、GA4のアクセスデータ、Google Search Consoleの検索データを取得して、スプレッドシートへ蓄積する。最初の目的には十分な仕組みでした。
ところが、BingやSNS、YouTubeまで対象を広げ、UTM経由の流入も追い、最終的にはAIに横断分析させたいと考えるようになると、必要なものが変わってきました。
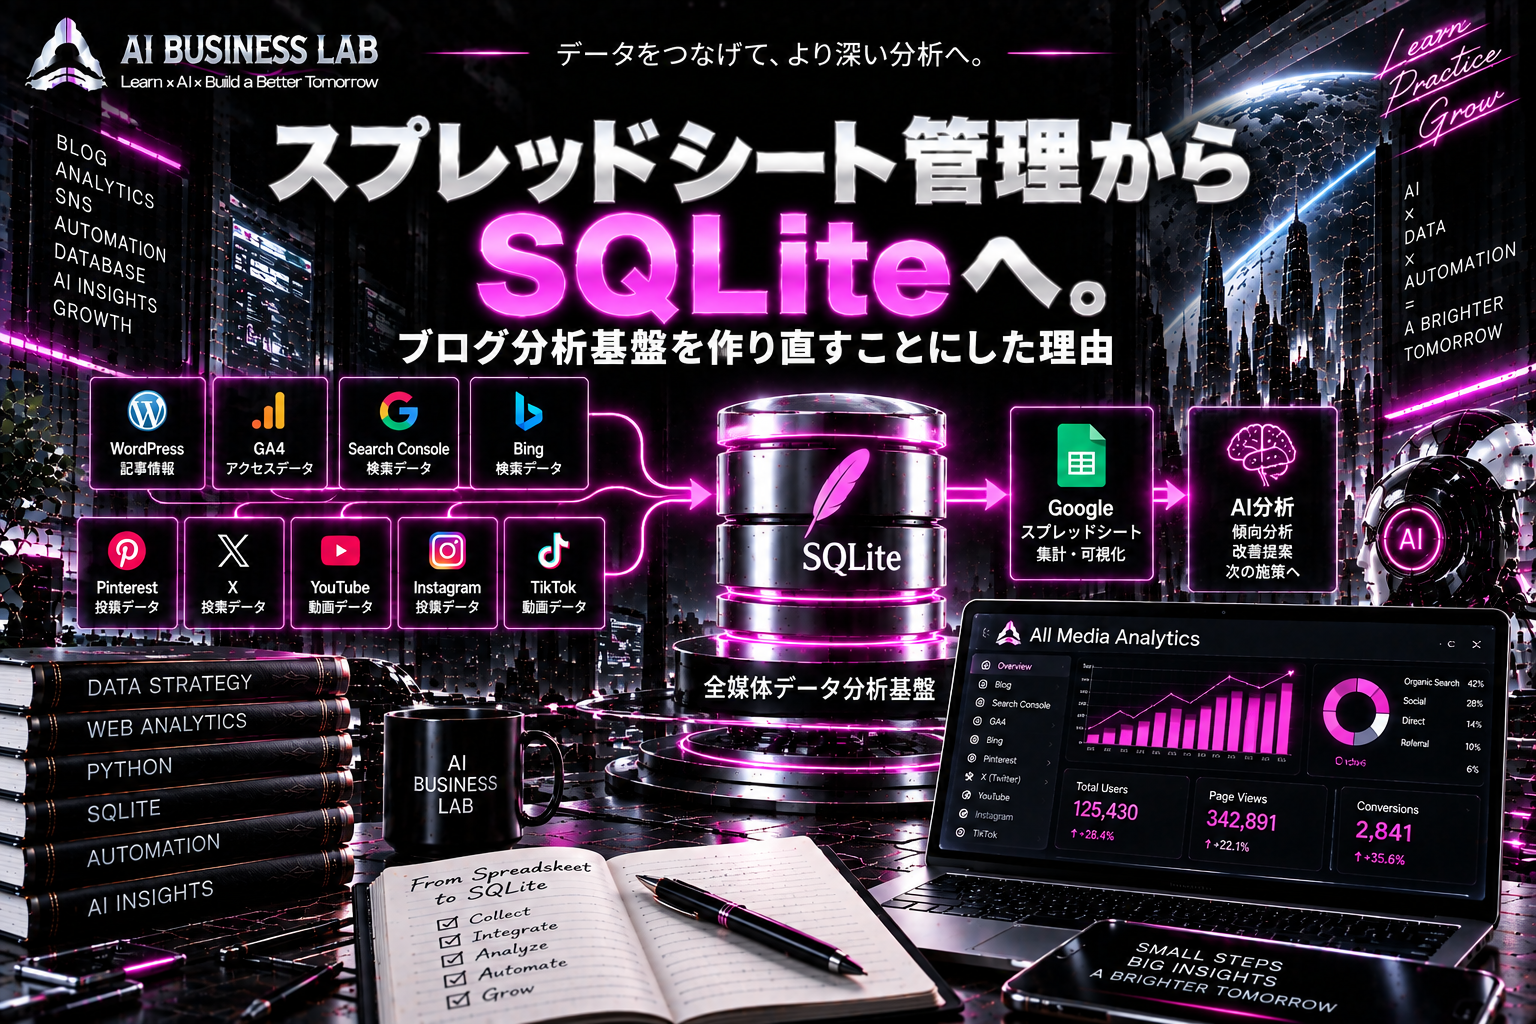
そこで現在、Python+SQLiteを中心とした「全媒体データ分析基盤」へ作り直しています。
この記事では、なぜスプレッドシート中心の設計からSQLiteへ移行することにしたのか、その経緯を整理します。
この記事で分かること
- GAS+スプレッドシートから始めた理由
- SQLiteへ移行することにした理由
- スプレッドシートとデータベースの役割の違い
- Python+SQLiteで目指している分析基盤
- 最初の仕組みを作ったことが無駄ではなかった理由
最初はGAS+スプレッドシートで十分だった
最初に作ろうとしていたのは、ブログの数値を自動取得する比較的シンプルな仕組みです。
WordPressから記事No、投稿ID、タイトル、URL、公開日、カテゴリーなどを取得し、GA4やSearch Consoleの数値と合わせて保存する。
スプレッドシートなら取得したデータをすぐ目で確認でき、フィルターや関数、グラフも使えます。GASを使えばGoogle系サービスとの連携や定期実行も組みやすいため、「ブログの数字を自動取得して確認する」という段階では使いやすい方法でした。
問題が出てきたのは、取得する数字が増えたからというより、データ同士の関係が増えたからです。
記事だけでなく「記事から何が生まれたか」を管理したくなった
例えば、一つのブログ記事からXやPinterestへ投稿し、さらに複数のショート動画を作ったとします。
それぞれにUTM付きURLを設定し、そこからブログへアクセスが発生すればGA4にもデータが残ります。
分析したい流れは、
ブログ記事 → SNS投稿・動画 → UTM付きリンク → ブログ流入 → サイト内行動
となります。
さらに同じ記事には、Search ConsoleやBingの検索データもあります。
スプレッドシートでも「記事」「SNS」「GA4」「Search Console」「UTM」などのシートを増やせば管理できます。しかし、記事No、URL、投稿ID、UTMなど、何と何を結び付けるのかが次第に複雑になります。
そこで、表を増やすのではなく、データ同士の関係を前提に保存する必要があると考えるようになりました。
SQLiteならデータの「関係」を持たせやすい
SQLiteは、別途データベースサーバーを用意せず利用でき、データベース全体を基本的に一つのファイルとして扱えるSQLデータベースです。PythonにもSQLiteを扱う標準のsqlite3モジュールがあります。現在のように一人で設計・実装・検証を繰り返す段階でも導入しやすいと判断しました。 (SQLite)
例えば、
記事AからSNS投稿Bを作った
投稿BではトラッキングリンクCを使った
リンクCにはUTM情報Dを設定した
という関係をIDで保存できます。
すると後から「この記事から作ったSNS投稿」「その投稿で使用したリンク」といった形でデータをたどれます。
今回欲しかったのは単なる数字の一覧ではなく、コンテンツがどのようにつながっているのかを保存できる構造でした。
Pythonへ移すことで処理も分離する
今回の変更では、保存先だけでなくプログラム全体の役割も分けることにしました。
APIから取得する処理、データを保存する処理、記事と投稿を紐付ける処理、集計する処理、人間向けに出力する処理、AIへ分析用データを渡す処理を分離します。
こうしておけば、ある媒体のAPI仕様が変わった場合でも、その取得部分を中心に修正できます。新しいSNSを追加するときも、既存処理へ無理に組み込むのではなく、新しい取得・保存処理として追加しやすくなります。
つまり、「GASよりPythonの方が優れているから変更した」わけではありません。
システムの目的が大きくなったため、それぞれの役割を分けて管理したくなったことが理由です。
分からないデータを無理につなげない
データベース設計を考える中でもう一つ重要だと感じたのが、すべての数字を無理に一致させないことです。
例えばSNS側でリンククリックが30回、GA4では24セッションだったとしても、計測方法が違えば数字が一致しないことがあります。
そこで、SNSのクリックはSNSの観測値、GA4のセッションはGA4の観測値として残します。
どの記事や投稿から来たのか特定できないデータも、無理にどこかへ紐付けたり削除したりせず、未解決の状態で保存します。
将来、紐付けルールを改善できれば再分析できるからです。
スプレッドシートは今後も使う
SQLiteへ移行しますが、Googleスプレッドシートを捨てるわけではありません。
むしろ役割を明確にします。
SQLite=データを保存し、関係を管理する場所
スプレッドシート=人間が結果を見る場所
という分担です。
記事別の直近30日データや、伸びている記事、検索パフォーマンス、SNS実績などはSQLite側で集計し、必要な結果だけスプレッドシートへ出力します。
裏側の細かなデータ構造と、人間が見る画面を分離する考え方です。
SQLiteも最終地点とは限らない
SQLiteはサーバーを別途管理する必要がなく、現在の開発規模には扱いやすい一方、同時書き込みなどには特性があります。SQLiteでは複数の読み取りは可能ですが、書き込みは同時に一つに制御されます。 (SQLite)
将来、クラウドで常時稼働させたり、複数システムから頻繁にアクセスしたりする段階になれば、PostgreSQLなど別のデータベースを検討する可能性もあります。Pythonの公式ドキュメントでも、SQLiteで試作した後に、より大規模なデータベースへ移行する使い方が示されています。 (Python documentation)
重要なのはSQLiteを使うこと自体ではなく、セル中心の管理から、データ同士の関係を中心に考える設計へ移ったことです。
最初からSQLiteにすればよかったわけではない
振り返ると、最初のGAS+スプレッドシート版も必要な段階だったと思います。
実際に作ったことで、どのデータが必要なのか、GA4とSearch Consoleをどう使い分けるのか、どんな数字を残したいのかが具体的に見えてきました。
その結果として、SNSやUTMまでつなぎたい、履歴を残したい、AIに分析させたいという次の要求が生まれています。
最初から完成形を設計しようとしても、ここまで具体的には考えられなかったはずです。
まとめ
今回の変更は、単純にGASからPythonへ乗り換えたという話ではありません。
最初は「ブログの数字を自動取得したい」という目的でした。それが実際に作り始めたことで、
記事 → 検索 → SNS・動画 → UTM → ブログ流入 → サイト内行動
まで保存し、最終的にはAIに横断分析させたいという構想へ広がりました。
そのため、スプレッドシートをデータ保存の中心にする設計から、Python+SQLiteでデータの関係を管理し、スプレッドシートは人間が見る場所として利用する設計へ変更しています。
最初から完成形を目指すのではなく、小さく作り、実際に必要になったものを確認しながら作り直す。
今回のSQLiteへの移行も、全媒体データ分析基盤を作る過程で必要になった一つの改善です。