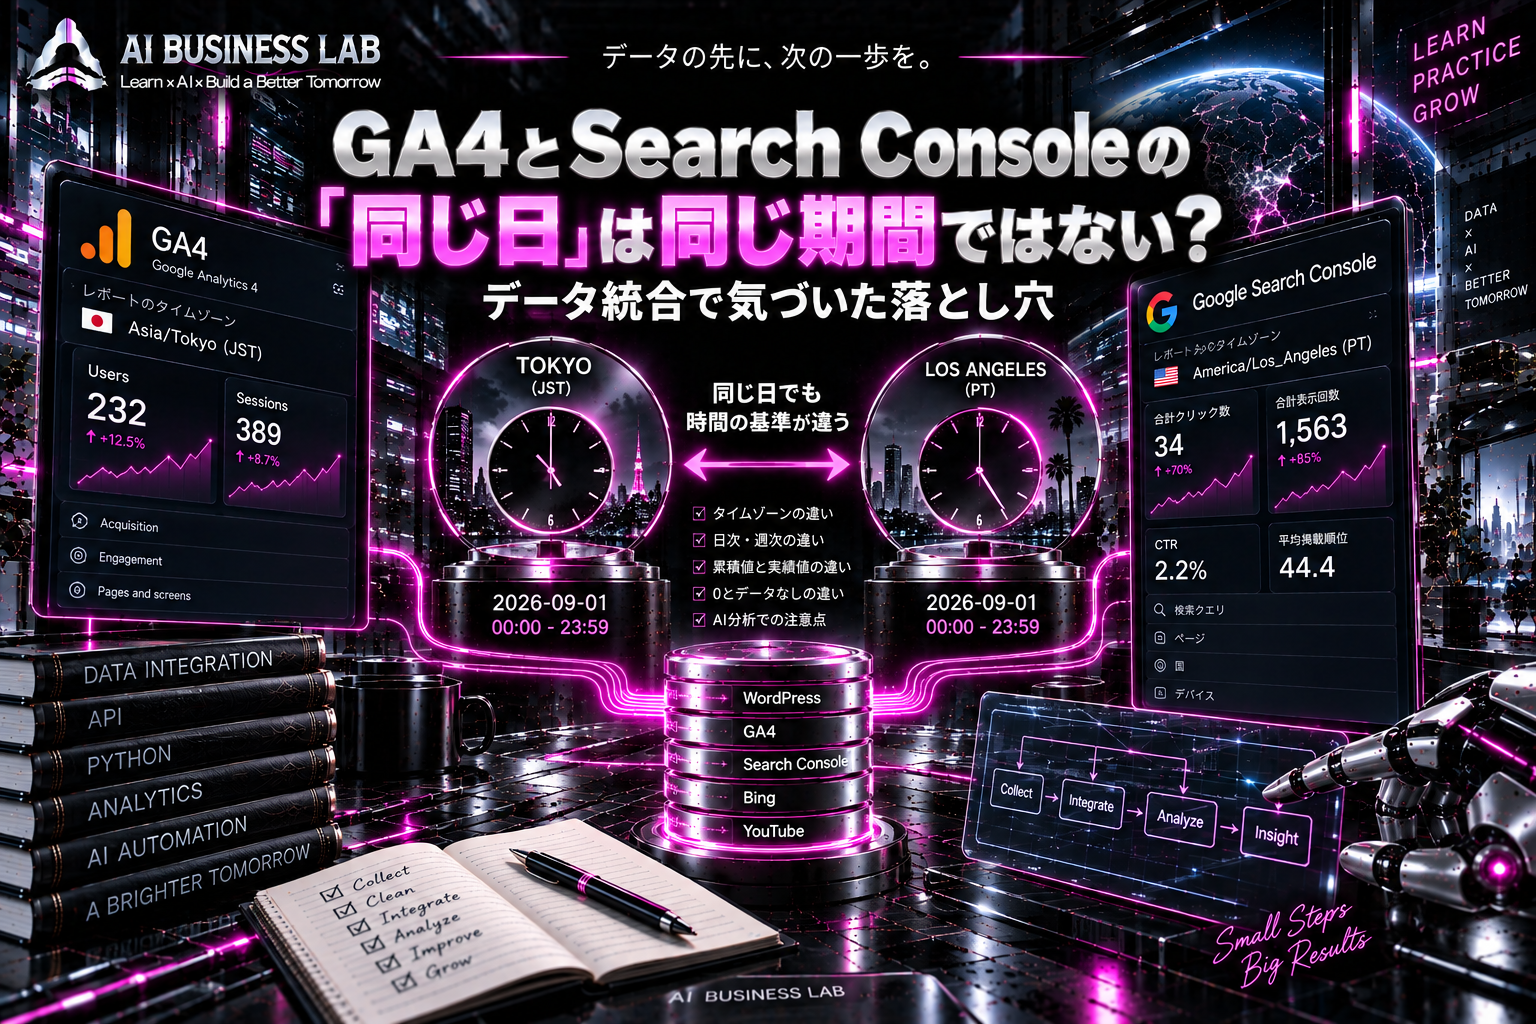
GA4とSearch Consoleの「同じ日」は同じ期間ではない?データ統合で気づいた落とし穴
ブログやSNSの数字を一か所へ集め、将来的にAIへ分析させる「全媒体データ分析基盤」を作っています。
WordPress、GA4、Google Search Console、Bing、YouTubeなどからデータを取得できるようになり、当初は「記事と日付をそろえれば横断分析できる」と考えていました。
ところが実際にSQLiteへ統合してみると、思った以上に注意点があります。
同じ日付でも集計している時間帯が違う。日次と週次が混在する。期間の実績値と累積値も違う。
今回は、複数媒体のデータを統合して初めて気づいた「数字の意味をそろえる難しさ」を整理します。
この記事で分かること
- GA4とSearch Consoleの日付を単純比較できない理由
- 日次・週次・累積値の違い
- 「0」と「データなし」を分ける必要性
- AI分析前に決めておきたいデータのルール
- 生データと分析用データを分ける考え方
同じ「9月1日」でも同じ24時間とは限らない
最初に気づいたのがタイムゾーンの問題です。
例えばデータベースに、
GA4:9月1日 セッション10
Search Console:9月1日 表示回数100
と保存されていれば、同じ日の数字として比較したくなります。
しかし、日付が同じだからといって、必ずしも同じ24時間を集計しているとは限りません。
GA4ではプロパティに設定したタイムゾーンがレポートの日付に影響します。一方、Search ConsoleのSearch Analytics APIでは日付が太平洋時間(PT)基準で扱われます。
たとえばGA4を日本時間で運用している場合、同じ「2026-09-01」でも集計区間にずれが生じます。
これはAI分析では特に注意が必要です。
「9月1日に検索表示が増え、その結果セッションも増えた」と分析させても、そもそも両者が同じ時間帯を見ていなければ、日次データだけから単純に関係づけるのは危険です。
日次データと週次データを無理にそろえない
次に考える必要があったのがデータの粒度です。
媒体によって、取得できるデータが必ずしも同じ細かさとは限りません。
仮に「1週間で700回表示」というデータしか取得できない場合、それを7で割って毎日100回として保存すれば、見た目はきれいになります。
しかし、実際に毎日100回表示された証拠はありません。
月曜日20回、火曜日50回、水曜日300回だった可能性もあります。
そのため現在は、
日次は日次、週次は週次のまま保存する
という考え方にしています。
データ統合というと、すべてを同じ形式へ変換したくなります。しかし、分からない部分まで補完してしまうと、分析しやすくなる代わりに事実から離れてしまいます。
「期間の実績値」と「累積値」も別物
YouTubeなどでは、さらに累積値を考える必要があります。
例えば動画の再生数を取得して、
9月10日時点:10,000回
9月11日時点:10,500回
だったとします。
これを合計して20,500回とすることはできません。
これは、その時点までの状態を記録した累積値だからです。
今回の設計では、こうした違いを分かりやすくするため、
flow=一定期間に発生した量
snapshot=ある時点で観測した状態
として区別することにしました。
1日のクリック数やセッション数ならflowとして扱えます。一方、取得時点の累積再生数や登録者数などはsnapshotとして扱います。
AIが分析するときにも、「足してよい数字なのか」「差分を見る数字なのか」が分からなければ正しい集計はできません。
「0」と「データなし」も分ける必要がある
もう一つ重要だったのが欠損値です。
YouTube再生数が0という場合でも、
動画を公開したが再生数が0だった
のと、
そもそも動画を作っていない
のでは意味が違います。
さらに、
API取得に失敗した
まだデータが反映されていない
対象コンテンツが存在しない
という場合もあります。
これらをすべて「0」と保存すると、AIは「投稿したが成果がなかった」と判断するかもしれません。
そこで、数値だけではなくなぜデータが存在しないのかも可能な範囲で残す必要があると考えるようになりました。
JOINすると数字が増える落とし穴もあった
データベースならではの問題もあります。
例えば、一つの記事からSNS投稿を5本作ったとします。その記事のGA4セッションが100だった場合、記事をキーにGA4とSNS投稿を単純結合すると、100セッションが5投稿それぞれに付くことがあります。
その状態で合計すれば、
本来100セッションなのに500セッション
になってしまいます。
このため、記事単位の数字と投稿単位の数字は、それぞれ正しい粒度で集計してから比較する必要があります。
SQLiteへ保存できたからといって、自動的に正しい分析データになるわけではありませんでした。
AIに分析させるため「分析契約」を作る
こうした問題を整理するため、今回のシステムでは分析契約を設けることにしました。
難しい仕組みではなく、
「このデータをどう解釈するか」
をあらかじめ決めておくルールです。
たとえば、タイムゾーン、集計期間、日次・週次、flow・snapshot、欠損理由、取得日時、記事単位・投稿単位などを明示します。
人間なら管理画面を見ながら感覚的に判断できる部分も、AIには伝わりません。
むしろAIは、間違ったデータでも自然な文章で分析できてしまいます。
AIの分析能力を高めるだけではなく、AIへ渡すデータの意味を保証することが必要だと分かってきました。
生データと分析用データを分ける
そこで、各APIから取得したデータを最初から無理に統一するのではなく、元の意味を保ったまま保存する方針にしています。
GoogleはGoogleの形式、BingはBingの形式、YouTubeはYouTubeの形式として残します。
そのうえで分析時に、期間・タイムゾーン・粒度・指標の意味などを整理した分析用データへ変換します。
つまり、
「一か所へ集める」ことと「一つの数字にする」ことは違う
ということです。
まとめ
全媒体データ分析基盤を作り始めた当初は、各APIから数字を取得してSQLiteへ保存すれば、そのままAI分析へ進めると思っていました。
しかし実際には、日付、タイムゾーン、粒度、累積値、欠損、取得日時、データの単位など、数字の背景まで管理する必要がありました。
特に重要だったのは、データをきれいにそろえるために、存在しない情報を作らないことです。
各媒体の違いを消すのではなく、違いを残したまま正しく比較できる状態を作る。
AIに大量の数字を渡すことより、その数字が何を意味しているのかを壊さず渡すことの方が難しい。
実際にデータ基盤を作ったことで、AI分析の前に必要な「地味なデータ設計」の重要性が見えてきました。